如何为人工智能工作负载和高性能网络选择下一代数据中心交换机

作者
凭借深厚的数据中心专业知识,X REACH 工程团队提供专为企业稳定性量身定制的高性能服务器和 AI 集群解决方案。我们采用独特的“现货+配送”模式和严格的质量控制,确保快速响应。
X REACH 工程团队


选择合适的交换机会影响GPU的利用率和作业完成速度。在AI数据中心,交换机必须始终以高速在GPU节点间传输流量,并保持低延迟和稳定性。任何一个薄弱环节都会拖慢集群操作,导致宝贵的计算资源闲置。
当你选择时,什么应该指导你的选择? 下一代数据中心交换机 对于人工智能和高性能网络而言,你需要的是对各项技术的公正比较和一份实用的检查清单,而不是供应商的宣传。
Ailink 将带您全面了解性能、应用契合度、合规性和成本。您将获得可以向团队充分论证的证据,并找到做出合理决策的清晰路径。
要点总结
选择与您的 AI 工作负载相匹配的开关。大型训练任务需要低延迟和高带宽。
使用真实的 AI 流量测试交换机。询问吞吐量、尾延迟和作业完成时间。
仔细调整拥塞控制参数,可以提升高达 40% 的性能。
检查电源效率。人工智能机架耗电量很大,所以要选择高效交换机。
权衡总成本。包括光学元件、许可证、电力和人员技能。
人工智能如何重塑开关需求
东西向交通和集体行动
传统商业网络主要承载南北向流量,也就是用户向服务器发送请求。人工智能集群的运行方式则截然不同。它们会产生庞大的东西向流量,这些流量在GPU、服务器和存储设备之间横向流动,而这种横向流量正是人工智能训练工作的核心。
分布式训练需要不断交换梯度、张量、模型参数并同步数据。借助数据、张量和流水线并行性,每个 GPU 可以同时与其他多个 GPU 通信。这会产生一些占用大量带宽的模式,例如 All-Reduce、All-Gather、Broadcast 和 Reduce-Scatter。
方面 | 人工智能集群中会发生什么 |
|---|---|
交通方向 | 东西向交通是主要交通流;南北向交通次之。 |
交通形状 | 少数几次持续时间长、影响巨大的流量,而不是许多小流量。 |
敏感性 | 集体网络对延迟、丢包、拥塞、抖动和过载反应强烈 |
集体操作对延迟非常敏感。即使是很小的同步延迟也会导致昂贵的GPU闲置,因此,稳定的低延迟比理论上的峰值吞吐量更为重要。网络架构采用脊叶式布局、无阻塞或低过载设计以及RDMA来降低延迟峰值。
传统设计的局限性
传统的叶脊式网络是为南北向流量设计的,流量通常较小且具有突发性。而人工智能工作负载则会产生少量但持续时间较长的庞大流量。每个加速器都会与其他加速器交换状态,任何一条路径上的延迟都会导致整个网络运行停滞。
这里的关键指标是尾延迟,而非平均延迟。数据流是同步的,因此最慢的数据包决定了整个操作何时结束。传统设计并未针对这一点进行优化。人工智能训练库也假设零丢包。一个丢包就可能导致大型数据集的重传,或者需要从检查点重新开始。
静态等价多路径和随机数据包喷射已不再适用。小修小补无法满足人工智能工作负载对性能的要求,因为这些工作负载的变化速度远超传统网络架构的适应速度。市场正朝着更高的能效、更少的网络内部时间以及更丰富的遥测数据方向发展。高性能、基于开放标准的以太网,其接口高达 800 GbE,并采用液冷设计,预示着未来的发展方向。Ailink 密切关注这些趋势,不偏袒任何一家厂商。
InfiniBand 与 Ultra Ethernet 的比较
性能、适配性、合规性、成本
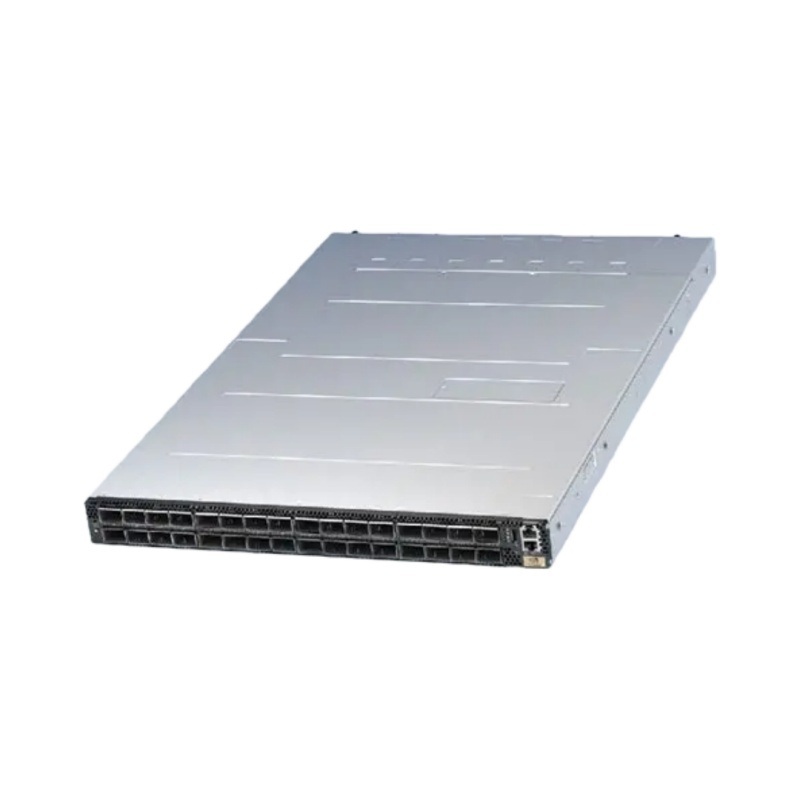
两种网络架构都能高速传输AI流量,区别在于实现方式。InfiniBand采用专用的无损网络架构,并支持网络内计算。以太网结合RoCE技术,将RDMA引入到用户熟悉的开放标准平台。下表展示了典型的InfiniBand平台在纸面上的对比。
规格 | NVIDIA MQM9790-NS2R Quantum-2 NDR InfiniBand 交换机 |
|---|---|
一代 | NDR 400G |
港口 | 64 x 400G(32 个 OSFP 连接器) |
聚合带宽 | 51.2 Tbps,无阻塞 |
切换延迟 | 亚微秒 |
网络内计算 | 夏普 v4 |
冷却 | 液体(QM9790);空气(QM9700) |
典型功率 | 约800–1200瓦 |
遵守 | IBTA规范v1.5 |
标价 | 30,000.00 美元 |
以太网选项,例如 戴尔网络 9700 系列中心交换机 其他支持 RoCE 的交换机在开放性和操作便捷性方面展开竞争。它们运行标准的以太网工具,并适用于多厂商环境。合规路径也各不相同。InfiniBand 遵循 IBTA v1.5 标准,而以太网则符合您的团队可能已经熟悉的 IEEE 和 RoCE 标准。
成本不仅仅是标价。NVIDIA交换机价格较高,其子网管理器和UFM工具还会增加许可和技能成本。以太网交换机通常每个端口的成本更低,并且可以利用现有员工的知识。功耗也很重要。一台满载的Quantum-2风冷交换机通常消耗800到1200瓦的功率,具体取决于光模块和流量负载。在决定购买之前,请将此数字与您的机架电源预算进行比较。
它们各自最适合的用途
基准测试结果揭示了更为细致的情况。在 MLPerf BERT-Large 训练测试中,以太网耗时 10,886 秒,InfiniBand 耗时 10,951 秒,以太网略胜一筹。而在 MLPerf LLAMA2-70B-99.9 推理测试中,InfiniBand 的速度提升了 1.66%。在多项生成式 AI 测试中,两者的性能几乎不相上下,差距不到 0.03%。因此,仅凭速度本身很难做出最终选择。
工作负载形状决定性因素更多。使用 8 个或更多 GPU 和数百亿个参数的大规模同步数据并行训练,能够充分利用 InfiniBand 的低延迟和高带宽优势。FSDP、ZeRO-3 和张量并行也受益匪浅,因为频繁的细粒度集合运算对延迟非常敏感。对于 700 亿级或以上、具有较大全局批处理的模型,互连带宽至关重要。
以太网在许多其他场景下也能很好地发挥作用。流水线并行处理较小的点对点激活流量,并能容忍一定的延迟。异步训练不存在同步障碍。2 到 4 个 GPU 的小型配置依赖于节点内部的 NVLink。推理服务几乎不需要 InfiniBand,因为 NVLink 可以处理节点内部流量,而高速以太网则覆盖了跨节点链路。
InfiniBand 适用于需要低于 5 微秒延迟的紧密耦合高性能计算 (HPC) 工作负载以及网络内计算,其中网络架构专用于单个租户和工作负载类型。对于多租户环境、混合工作负载或希望避免对特定供应商依赖的组织而言,采用合适架构的现代以太网是一个可靠的替代方案。
两种选择都可行。根据您的工作负载、团队技能和预算来选择合适的架构。Ailink 帮助您权衡两种方案,选择下一代数据中心交换机,而无需偏袒任何一家供应商。
下一代交换机的关键特性
带宽、延迟、拥塞控制
端口速度现已达到 800 GbE,而高密度 100G、200G 和 400G 端口也能满足当今 GPU 的带宽需求。然而,原始速度仅仅是开始。四项关键能力决定了您的网络架构能否与加速器保持同步。
能力 | 需要注意什么 | 为什么这很重要 |
|---|---|---|
带宽和端口密度 | 100G、200G、400G 和新增的 800G 端口 | 满足分布式训练团队所需的带宽 |
延迟 | 端口间延迟稳定低,负载下无抖动 | 防止同步群体中出现掉队者 |
缓冲 | 深度动态共享缓冲区 | 能吸收微爆流和内灌流而不滴水 |
拥堵控制 | RoCEv2 具备 DCQCN、ECN 标记和 802.1Qbb 下的 PFC 功能 | 保持 RoCE 传输无损和吞吐量稳定 |
拥塞控制值得深入研究。DCQCN 允许网卡对 ECN 标记做出响应,而 ECN 会在交换机丢弃数据包之前对其进行标记。PFC 会暂停特定的 CoS 优先级数据包,以保护无损 RoCE 流量。OCI 构建了一个可扩展至数千个节点的 RoCE 网络,并针对延迟敏感型、吞吐量敏感型和混合型工作负载定义了至少三种拥塞控制配置文件。它仅在主机和机架顶部交换机之间的边缘单向应用 PFC,而不会应用到叶交换机或脊交换机,从而避免了队头阻塞。ECN 使得 PFC 很少需要作为最后的安全措施。较小的集群可以在交换机上不配置 PFC 或 ECN 的情况下运行零接触 RoCE。
在不采取缓解措施的情况下,不均匀的流量分布和上行链路拥塞导致一次部署中的训练性能下降超过 30%。通过交换机用户自定义函数 (UDF) 对目标 QP 进行哈希处理,并结合 QP 扩展,可使 AllReduce 的性能提升高达 40%。接收方驱动的准入机制(其中库和传输层交换可发送数据包)进一步限制了传输中的流量。
可扩展性、可编程性、遥测
将可扩展性、可编程性和遥测功能视为选择标准,而非附加功能。要考虑网络架构如何扩展到数千个节点以上,交换机是否提供流级遥测功能,以及团队需要掌握多少配置信息。运维连续性同样重要。基于 Dell OS10 的交换机为重视命令行界面 (CLI) 的团队保留了熟悉的 CLI,而 Dell Networking 9700 系列中心交换机则适用于基于该工具标准化的环境。
根据这些标准选择下一代数据中心交换机,然后在购买前用您自己的流量进行测试。
真实世界测试揭示了什么
来自人工智能织物的基准数据
签约前,务必索取实际数据:例如吞吐量、尾延迟以及运行实际 AI 流量的链路的作业完成时间。销售资料很少包含这些数据。请向供应商和 Ailink 索取。
已公布的记录显示,两种网络架构的性能都相当不错。Meta 为其 Llama 3 部署构建了两个 AI 集群,一个基于 InfiniBand,另一个基于 Arista 以太网。Meta 报告称,两种网络架构均未出现网络瓶颈。Meta 还分享了一个拥有 24,000 个 GPU 的 RoCE 集群的工程细节。在该集群中,RoCE 和 InfiniBand 都经过调优,性能相近,并且最大的模型是在 RoCE 网络上训练的。在 NCCL 测试中,RoCE 以太网的总通信带宽与 InfiniBand 相当。MLPerf 风格的实验室测试显示,作业时间差异仅为百分之几。
尾延迟仍然是两者之间的主要区别。InfiniBand 基于信用的流量控制消除了丢包,并实现了非常稳定的最坏情况性能。经过良好调优的 AI 以太网性能接近 InfiniBand,但 PFC 配置不当会导致队头阻塞或死锁。xAI 的 Colossus 超级计算机通过 Spectrum-X 以太网连接了 10 万个 NVIDIA Hopper GPU。在针对突发性 AI 训练进行优化的拥塞控制下,其数据吞吐量达到了 95%。而同等规模的传统以太网由于数千次流量冲突,吞吐量最高只能达到 60% 左右。
从已部署集群中汲取的经验教训
已投入使用的集群为我们提供了选择合适工具的经验教训。一个团队在集群上运行紧密耦合的同步训练。 NVIDIA MQM9790-NS2R Quantum-2 NDR InfiniBand 交换机 实现稳定的尾部延迟和网络内计算。采用戴尔 9700 系列中心交换机并采用开放式以太网的团队,可以获得熟悉的操作体验和跨厂商的灵活性。
芯片和负载均衡的选择也会影响作业完成时间。与同类芯片相比,博通 Jericho3-AI 将作业完成时间缩短了 10% 以上。Arista 7800R4 HyperPort 将 4×800Gbps 的带宽捆绑成 3.2Tbps,与传统的跨独立端口负载均衡相比,作业完成时间缩短了 44%。请将这些结果视为测试的理由,而非最终答案。在选择下一代数据中心交换机时,请务必在您自己的网络架构上进行测试。
如何选择下一代数据中心交换机
构建评估清单
一份好的清单可以将模糊的比较转化为可以据此做出的决定。从六个方面对每个候选机构进行评分,并根据自身情况为每个方面赋予不同的权重。下表说明了为什么人工智能设施需要与传统礼堂不同的答案。
标准区域 | 传统数据中心 | 人工智能数据中心 |
|---|---|---|
工作负荷匹配 | 稳定、可预测的工作负载 | 动态、突发、数据密集型工作负载 |
机架功率密度 | 7–10 千瓦/机架 | 每机架功率从 30 千瓦到超过 100 千瓦不等。 |
冷却 | 主要采用空气冷却 | 液冷或混合冷却 |
联网 | 标准以太网 | 超高带宽、低延迟互连 |
首先要考虑工作负载匹配度。询问交换机能否在多个 GPU 节点上保持高吞吐量和低延迟,以及能否很好地处理东西向流量。接下来,测试其在真实 AI 流量下的性能,而不是实验室突发流量。然后,确认部署的每个区域都符合相关规范,因为全球布局可以确保产品设计的一致性并加快部署速度。
能效值得单独列出。高密度AI机架的功耗如今已达到30千瓦到100千瓦以上,NVIDIA GB200 NVL36的功耗约为66千瓦,而NVL72的功耗则高达约120千瓦。现代800G OSFP可插拔模块相比上一代产品,每千兆成本降低了约40%,并通过先进的DSP和调制技术实现了约50%的节能。此外,还应将遥测数据作为一项评分指标。实时掌握能耗和基础设施负载情况有助于避免停机,而机器学习模型则可以在故障发生前预警冷却性能下降或光纤信号衰减。最后,还应考虑总成本,包括光模块、许可、电力和人员技能等因素。
使用Ailink进行验证
一份清单可以缩小选择范围,而测试才能最终确定。在您正式采购之前,Ailink 可以帮助您的团队针对您自身的 AI 工作负载验证下一代数据中心交换机。您只需提供流量概况、群体模式和功耗预算,Ailink 将根据这些信息制定测试计划。
整个流程遵循清晰的步骤。首先,您需要定义重要的工作负载,例如同步训练和推理服务。其次,Ailink 会对候选网络架构进行吞吐量、尾延迟和作业完成时间测试。第三,您需要在持续负载下查看遥测输出和功耗。第四,您需要比较整个部署方案的总成本。
这种方法让您能够根据事实而非营销宣传来选择下一代数据中心交换机。通过这种方式选择下一代数据中心交换机,您的团队可以在下订单之前看到相关数据。爱凌销售此处比较的所有选项,因此指南保持中立,测试结果本身就足以说明一切。
选择设备时应考虑五个方面:它与工作负载的匹配度、在人工智能流量下的实际运行速度、合规性、能效以及总成本。综合考虑所有这些因素,任何单一的规格参数都无法左右你的决定。
对每个候选平台运行检查清单。向运行真实 AI 流量的平台索取基准数据。然后与……合作 爱林克 在做出决定之前,先针对自身工作负载测试各种方案。这些测试结果能让您更有信心地选择下一代数据中心交换机,您的团队也能从数据中看到决策背后的依据。
常问问题
大型同步训练应该选择哪种面料?
InfiniBand 最适合紧密耦合的训练。其基于信用的流量控制可保持尾延迟稳定,而网络内计算则可加快集体训练的速度。以太网搭配 RoCE 也能很好地工作,前提是您需要调整拥塞控制。在决定使用哪种网络架构之前,请务必根据您的工作负载结构、团队技能和预算进行选择。
拥堵控制究竟能对结果产生多大影响?
这会造成很大变化。一个部署由于流量不均衡和上行链路拥塞,训练性能损失超过 30%。在目标 QP 上进行哈希处理并采用 QP 扩展,AllReduce 的性能恢复了高达 40%。请仔细调整 ECN 和 PFC,并在您自己的突发流量环境下进行测试。
您现在需要 800 GbE 端口吗?
并非总是如此。高密度 100G、200G 和 400G 端口足以满足目前大多数 GPU 的需求。只有当您的发展规划需要时,才应选择 800GbE。现代 800G OSFP 模块可将每千兆成本降低约 40%,并节省约 50% 的功耗,因此从长远来看,升级是值得的。
如何公平地比较不同供应商?
从工作负载匹配度、实际性能、合规性、能效、遥测数据和总成本等方面对每个候选方案进行评分。要求从实际的 AI 架构中获取吞吐量、尾延迟和作业完成时间等数据。然后,在您最终确定方案之前,让 Ailink 根据您自己的流量特征对候选方案进行测试。
权力在决策中扮演什么角色?
这是一个很大的问题。人工智能机架的功耗现在从 30 千瓦到 100 千瓦以上不等,NVIDIA GB200 NVL72 显卡的功耗约为 120 千瓦。一台满载的风冷 Quantum-2 交换机的功耗约为 800 到 1200 瓦。务必尽早将每个参数与您的机架功率和散热预算进行核对。