• 如何为人工智能工作负载和高性能网络选择下一代数据中心交换机
    October 26, 2026
    选择合适的交换机会影响GPU的利用率和作业完成速度。在AI数据中心,交换机必须始终以高速在GPU节点间传输流量,并保持低延迟和稳定性。任何一个薄弱环节都会拖慢集群操作,导致宝贵的计算资源闲置。当你选择时,什么应该指导你的选择? 下一代数据中心交换机 对于人工智能和高性能网络而言,你需要的是对各项技术的公正比较和一份实用的检查清单,而不是供应商的宣传。Ailink 将带您全面了解性能、应用契合度、合规性和成本。您将获得可以向团队充分论证的证据,并找到做出合理决策的清晰路径。要点总结选择与您的 AI 工作负载相匹配的开关。大型训练任务需要低延迟和高带宽。使用真实的 AI 流量测试交换机。询问吞吐量、尾延迟和作业完成时间。仔细调整拥塞控制参数,可以提升高达 40% 的性能。检查电源效率。人工智能机架耗电量很大,所以要选择高效交换机。权衡总成本。包括光学元件、许可证、电力和人员技能。人工智能如何重塑开关需求东西向交通和集体行动传统商业网络主要承载南北向流量,也就是用户向服务器发送请求。人工智能集群的运行方式则截然不同。它们会产生庞大的东西向流量,这些流量在GPU、服务器和存储设备之间横向流动,而这种横向流量正是人工智能训练工作的核心。分布式训练需要不断交换梯度、张量、模型参数并同步数据。借助数据、张量和流水线并行性,每个 GPU 可以同时与其他多个 GPU 通信。这会产生一些占用大量带宽的模式,例如 All-Reduce、All-Gather、Broadcast 和 Reduce-Scatter。方面人工智能集群中会发生什么交通方向东西向交通是主要交通流;南北向交通次之。交通形状少数几次持续时间长、影响巨大的流量,而不是许多小流量。敏感性集体网络对延迟、丢包、拥塞、抖动和过载反应强烈集体操作对延迟非常敏感。即使是很小的同步延迟也会导致昂贵的GPU闲置,因此,稳定的低延迟比理论上的峰值吞吐量更为重要。网络架构采用脊叶式布局、无阻塞或低过载设计以及RDMA来降低延迟峰值。传统设计的局限性传统的叶脊式网络是为南北向流量设计的,流量通常较小且具有突发性。而人工智能工作负载则会产生少量但持续时间较长的庞大流量。每个加速器都会与其他加速器交换状态,任何一条路径上的延迟都会导致整个网络运行停滞。这里的关键指标是尾延迟,而非平均延迟。数据流是同步的,因此最慢的数据包决定了整个操作何时结束。传统设计并未针对这一点进行优化。人工智能训练库也假设零丢包。一个丢包就可能导致大型数据集的重传,或者需要从检查点重新开始。静态等价多路径和随机数据包喷射已不再适用。小修小补无法满足人工智能工作负载对性能的要求,因为这些工作负载的变化速度远超传统网络架构的适应速度。市场正朝着更高的能效、更少的网络内部时间以及更丰富的遥测数据方向发展。高性能、基于开放标准的以太网,其接口高达 800 GbE,并采用液冷设计,预示着未来的发展方向。Ailink 密切关注这些趋势,不偏袒任何一家厂商。InfiniBand 与 Ultra Ethernet 的比较性能、适配性、合规性、成本两种网络架构都能高速传输AI流量,区别在于实现方式。InfiniBand采用专用的无损网络架构,并支持网络内计算。以太网结合RoCE技术,将RDMA引入到用户熟悉的开放标准平台。下表展示了典型的InfiniBand平台在纸面上的对比。规格NVIDIA MQM9790-NS2R Quantum-2 NDR InfiniBand 交换机一代NDR 400G港口64 x 400G(32 个 OSFP 连接器)聚合带宽51.2 Tbps,无阻塞切换延迟亚微秒网络内计算夏普 v4冷却液体(QM9790);空气(QM9700)典型功率约800–1200瓦遵守IBTA规范v1.5标价30,000.00 美元以太网选项,例如 戴尔网络 9700 系列中心交换机 其他支持 RoCE 的交换机在开放性和操作便捷性方面展开竞争。它们运行标准的以太网工具,并适用于多厂商环境。合规路径也各不相同。InfiniBand 遵循 IBTA v1.5 标准,而以太网则符合您的团队可能已经熟悉的 IEEE 和 RoCE 标准。成本不仅仅是标价。NVIDIA交换机价格较高,其子网管理器和UFM工具还会增加许可和技能成本。以太网交换机通常每个端口的成本更低,并且可以利用现有员工的知识。功耗也很重要。一台满载的Quantum-2风冷交换机通常消耗800到1200瓦的功率,具体取决于光模块和流量负载。在决定购买之前,请将此数字与您的机架电源预算进行比较。它们各自最适合的用途基准测试结果揭示了更为细致的情况。在 MLPerf BERT-Large 训练测试中,以太网耗时 10,886 秒,InfiniBand 耗时 10,951 秒,以太网略胜一筹。而在 MLPerf LLAMA2-70B-99.9 推理测试中,InfiniBand 的速度提升了 1.66%。在多项生成式 AI 测试中,两者的性能几乎不相上下,差距不到 0.03%。因此,仅凭速度本身很难做出最终选择。工作负载形状决定性因素更多。使用 8 个或更多 GPU 和数百亿个参数的大规模同步数据并行训练,能够充分利用 InfiniBand 的低延迟和高带宽优势。FSDP、ZeRO-3 和张量并行也受益匪浅,因为频繁的细粒度集合运算对延迟非常敏感。对于 700 亿级或以上、具有较大全局批处理的模型,互连带宽至关重要。以太网在许多其他场景下也能很好地发挥作用。流水线并行处理较小的点对点激活流量,并能容忍一定的延迟。异步训练不存在同步障碍。2 到 4 个 GPU 的小型配置依赖于节点内部的 NVLink。推理服务几乎不需要 InfiniBand,因为 NVLink 可以处理节点内部流量,而高速以太网则覆盖了跨节点链路。InfiniBand 适用于需要低于 5 微秒延迟的紧密耦合高性能计算 (HPC) 工作负载以及网络内计算,其中网络架构专用于单个租户和工作负载类型。对于多租户环境、混合工作负载或希望避免对特定供应商依赖的组织而言,采用合适架构的现代以太网是一个可靠的替代方案。两种选择都可行。根据您的工作负载、团队技能和预算来选择合适的架构。Ailink 帮助您权衡两种方案,选择下一代数据中心交换机,而无需偏袒任何一家供应商。下一代交换机的关键特性带宽、延迟、拥塞控制端口速度现已达到 800 GbE,而高密度 100G、200G 和 400G 端口也能满足当今 GPU 的带宽需求。然而,原始速度仅仅是开始。四项关键能力决定了您的网络架构能否与加速器保持同步。能力需要注意什么为什么这很重要带宽和端口密度100G、200G、400G 和新增的 800G 端口满足分布式训练团队所需的带宽延迟端口间延迟稳定低,负载下无抖动防止同步群体中出现掉队者缓冲深度动态共享缓冲区能吸收微爆流和内灌流而不滴水拥堵控制RoCEv2 具备 DCQCN、ECN 标记和 802.1Qbb 下的 PFC 功能保持 RoCE 传输无损和吞吐量稳定拥塞控制值得深入研究。DCQCN 允许网卡对 ECN 标记做出响应,而 ECN 会在交换机丢弃数据包之前对其进行标记。PFC 会暂停特定的 CoS 优先级数据包,以保护无损 RoCE 流量。OCI 构建了一个可扩展至数千个节点的 RoCE 网络,并针对延迟敏感型、吞吐量敏感型和混合型工作负载定义了至少三种拥塞控制配置文件。它仅在主机和机架顶部交换机之间的边缘单向应用 PFC,而不会应用到叶交换机或脊交换机,从而避免了队头阻塞。ECN 使得 PFC 很少需要作为最后的安全措施。较小的集群可以在交换机上不配置 PFC 或 ECN 的情况下运行零接触 RoCE。在不采取缓解措施的情况下,不均匀的流量分布和上行链路拥塞导致一次部署中的训练性能下降超过 30%。通过交换机用户自定义函数 (UDF) 对目标 QP 进行哈希处理,并结合 QP 扩展,可使 AllReduce 的性能提升高达 40%。接收方驱动的准入机制(其中库和传输层交换可发送数据包)进一步限制了传输中的流量。可扩展性、可编程性、遥测将可扩展性、可编程性和遥测功能视为选择标准,而非附加功能。要考虑网络架构如何扩展到数千个节点以上,交换机是否提供流级遥测功能,以及团队需要掌握多少配置信息。运维连续性同样重要。基于 Dell OS10 的交换机为重视命令行界面 (CLI) 的团队保留了熟悉的 CLI,而 Dell Networking 9700 系列中心交换机则适用于基于该工具标准化的环境。根据这些标准选择下一代数据中心交换机,然后在购买前用您自己的流量进行测试。真实世界测试揭示了什么来自人工智能织物的基准数据签约前,务必索取实际数据:例如吞吐量、尾延迟以及运行实际 AI 流量的链路的作业完成时间。销售资料很少包含这些数据。请向供应商和 Ailink 索取。已公布的记录显示,两种网络架构的性能都相当不错。Meta 为其 Llama 3 部署构建了两个 AI 集群,一个基于 InfiniBand,另一个基于 Arista 以太网。Meta 报告称,两种网络架构均未出现网络瓶颈。Meta 还分享了一个拥有 24,000 个 GPU 的 RoCE 集群的工程细节。在该集群中,RoCE 和 InfiniBand 都经过调优,性能相近,并且最大的模型是在 RoCE 网络上训练的。在 NCCL 测试中,RoCE 以太网的总通信带宽与 InfiniBand 相当。MLPerf 风格的实验室测试显示,作业时间差异仅为百分之几。尾延迟仍然是两者之间的主要区别。InfiniBand 基于信用的流量控制消除了丢包,并实现了非常稳定的最坏情况性能。经过良好调优的 AI 以太网性能接近 InfiniBand,但 PFC 配置不当会导致队头阻塞或死锁。xAI 的 Colossus 超级计算机通过 Spectrum-X 以太网连接了 10 万个 NVIDIA Hopper GPU。在针对突发性 AI 训练进行优化的拥塞控制下,其数据吞吐量达到了 95%。而同等规模的传统以太网由于数千次流量冲突,吞吐量最高只能达到 60% 左右。从已部署集群中汲取的经验教训已投入使用的集群为我们提供了选择合适工具的经验教训。一个团队在集群上运行紧密耦合的同步训练。 NVIDIA MQM9790-NS2R Quantum-2 NDR InfiniBand 交换机 实现稳定的尾部延迟和网络内计算。采用戴尔 9700 系列中心交换机并采用开放式以太网的团队,可以获得熟悉的操作体验和跨厂商的灵活性。芯片和负载均衡的选择也会影响作业完成时间。与同类芯片相比,博通 Jericho3-AI 将作业完成时间缩短了 10% 以上。Arista 7800R4 HyperPort 将 4×800Gbps 的带宽捆绑成 3.2Tbps,与传统的跨独立端口负载均衡相比,作业完成时间缩短了 44%。请将这些结果视为测试的理由,而非最终答案。在选择下一代数据中心交换机时,请务必在您自己的网络架构上进行测试。如何选择下一代数据中心交换机构建评估清单一份好的清单可以将模糊的比较转化为可以据此做出的决定。从六个方面对每个候选机构进行评分,并根据自身情况为每个方面赋予不同的权重。下表说明了为什么人工智能设施需要与传统礼堂不同的答案。标准区域传统数据中心人工智能数据中心工作负荷匹配稳定、可预测的工作负载动态、突发、数据密集型工作负载机架功率密度7–10 千瓦/机架每机架功率从 30 千瓦到超过 100 千瓦不等。冷却主要采用空气冷却液冷或混合冷却联网标准以太网超高带宽、低延迟互连首先要考虑工作负载匹配度。询问交换机能否在多个 GPU 节点上保持高吞吐量和低延迟,以及能否很好地处理东西向流量。接下来,测试其在真实 AI 流量下的性能,而不是实验室突发流量。然后,确认部署的每个区域都符合相关规范,因为全球布局可以确保产品设计的一致性并加快部署速度。能效值得单独列出。高密度AI机架的功耗如今已达到30千瓦到100千瓦以上,NVIDIA GB200 NVL36的功耗约为66千瓦,而NVL72的功耗则高达约120千瓦。现代800G OSFP可插拔模块相比上一代产品,每千兆成本降低了约40%,并通过先进的DSP和调制技术实现了约50%的节能。此外,还应将遥测数据作为一项评分指标。实时掌握能耗和基础设施负载情况有助于避免停机,而机器学习模型则可以在故障发生前预警冷却性能下降或光纤信号衰减。最后,还应考虑总成本,包括光模块、许可、电力和人员技能等因素。使用Ailink进行验证一份清单可以缩小选择范围,而测试才能最终确定。在您正式采购之前,Ailink 可以帮助您的团队针对您自身的 AI 工作负载验证下一代数据中心交换机。您只需提供流量概况、群体模式和功耗预算,Ailink 将根据这些信息制定测试计划。整个流程遵循清晰的步骤。首先,您需要定义重要的工作负载,例如同步训练和推理服务。其次,Ailink 会对候选网络架构进行吞吐量、尾延迟和作业完成时间测试。第三,您需要在持续负载下查看遥测输出和功耗。第四,您需要比较整个部署方案的总成本。这种方法让您能够根据事实而非营销宣传来选择下一代数据中心交换机。通过这种方式选择下一代数据中心交换机,您的团队可以在下订单之前看到相关数据。爱凌销售此处比较的所有选项,因此指南保持中立,测试结果本身就足以说明一切。选择设备时应考虑五个方面:它与工作负载的匹配度、在人工智能流量下的实际运行速度、合规性、能效以及总成本。综合考虑所有这些因素,任何单一的规格参数都无法左右你的决定。对每个候选平台运行检查清单。向运行真实 AI 流量的平台索取基准数据。然后与……合作 爱林克 在做出决定之前,先针对自身工作负载测试各种方案。这些测试结果能让您更有信心地选择下一代数据中心交换机,您的团队也能从数据中看到决策背后的依据。常问问题大型同步训练应该选择哪种面料?InfiniBand 最适合紧密耦合的训练。其基于信用的流量控制可保持尾延迟稳定,而网络内计算则可加快集体训练的速度。以太网搭配 RoCE 也能很好地工作,前提是您需要调整拥塞控制。在决定使用哪种网络架构之前,请务必根据您的工作负载结构、团队技能和预算进行选择。拥堵控制究竟能对结果产生多大影响?这会造成很大变化。一个部署由于流量不均衡和上行链路拥塞,训练性能损失超过 30%。在目标 QP 上进行哈希处理并采用 QP 扩展,AllReduce 的性能恢复了高达 40%。请仔细调整 ECN 和 PFC,并在您自己的突发流量环境下进行测试。您现在需要 800 GbE 端口吗?并非总是如此。高密度 100G、200G 和 400G 端口足以满足目前大多数 GPU 的需求。只有当您的发展规划需要时,才应选择 800GbE。现代 800G OSFP 模块可将每千兆成本降低约 40%,并节省约 50% 的功耗,因此从长远来看,升级是值得的。如何公平地比较不同供应商?从工作负载匹配度、实际性能、合规性、能效、遥测数据和总成本等方面对每个候选方案进行评分。要求从实际的 AI 架构中获取吞吐量、尾延迟和作业完成时间等数据。然后,在您最终确定方案之前,让 Ailink 根据您自己的流量特征对候选方案进行测试。权力在决策中扮演什么角色?这是一个很大的问题。人工智能机架的功耗现在从 30 千瓦到 100 千瓦以上不等,NVIDIA GB200 NVL72 显卡的功耗约为 120 千瓦。一台满载的风冷 Quantum-2 交换机的功耗约为 800 到 1200 瓦。务必尽早将每个参数与您的机架功率和散热预算进行核对。
  • AI服务器硬件要求:GPU、内存、存储和网络实用检查清单
    October 20, 2026
    AI服务器硬件要求:GPU、内存、存储和网络实用检查清单 构建人工智能服务器需要的不仅仅是选择一块强大的GPU。一个可靠的 AI服务器配置 必须平衡计算性能、系统内存、存储吞吐量、网络带宽、电源供应和散热,才能有效地支持特定的工作负载。 无论您是部署 AI 推理服务、微调机器学习模型、训练大型语言模型 (LLM),还是构建 AI 数据基础设施,理解都至关重要。 AI服务器硬件要求 对于避免兼容性问题、性能瓶颈和不必要的采购成本至关重要。本指南解释了 AI 服务器的关键组件、如何为不同的 AI 工作负载选择硬件,以及在购买服务器组件之前需要检查哪些内容。 1. 在选择硬件之前,先考虑人工智能工作负载。右 AI服务器硬件 主要取决于系统需要完成的任务。不同的工作负载对GPU内存、系统内存、存储容量和网络性能的要求各不相同。在选择组件之前,请明确工作负载、预期性能、数据量和未来扩展需求。 AI模型训练与AI推理人工智能模型训练 它涉及处理大型数据集并反复更新模型参数。这通常需要强大的加速器计算能力、足够的GPU内存、高内存带宽和高效的数据传输。 人工智能推理 它使用训练好的模型来生成预测、分类或响应。其硬件要求取决于模型大小、输入输出长度、并发用户数、延迟目标和吞吐量预期。 例如,支持相对小型模型的推理服务器可能会优先考虑GPU内存容量和成本效益。分布式训练环境可能需要多个加速器和高带宽网络来协调跨服务器的计算任务。 微调、RAG 和数据分析其他人工智能应用对基础设施的要求各不相同。模型微调: 需要足够的加速器内存、系统内存和用于存储数据集和检查点的快速存储。检索增强生成(RAG): 文档处理和检索服务可能需要结合使用 GPU 资源、CPU 容量、快速存储和内存。人工智能数据分析: 通常情况下,均衡的 CPU、内存、存储和网络资源对于数据准备和处理是有益的。大规模分布式训练: 需要仔细规划加速器互连、网络拓扑、存储吞吐量和工作负载同步。 单服务器与多节点人工智能基础设施对于较小的工作负载,单服务器配置可以简化部署和管理。而较大的AI项目可能需要通过高性能网络连接多台服务器。 规划多节点环境时,不仅要考虑单个服务器的规格,还要考虑节点间的数据传输方式。如果网络拥塞导致数据或同步频繁延迟,即使是强大的GPU也无法发挥其全部潜力。 2. AI服务器的核心硬件组件了解每个组件的功能有助于买家打造平衡的方案。 AI服务器配置 而不是仅仅根据主要规格来选择单个零件。 GPU 和 CPU:构建计算基础图形处理器 (GPU) 和其他人工智能加速器承担了现代人工智能工作负载所需的大部分并行计算。它们的适用性取决于模型、精度要求、内存容量、支持的软件以及预期性能。 评估时 GPU 服务器组件, 考虑:加速器内存容量和内存带宽针对预期工作负载的计算性能平台支持的加速器数量PCIe 连接和可用扩展插槽功耗、散热和物理尺寸软件、驱动程序和框架兼容性CPU 对于数据准备、编排、存储操作以及其他支持加速器工作负载的任务仍然非常重要。对于多GPU系统,请确认主板、CPU、机箱和电源能够支持预期的配置。仅凭物理插槽的可用性并不能保证所有GPU都能以预期的连接性和性能运行。 服务器内存:容量、带宽和可靠性系统内存存储运行数据、中间结果、应用程序进程以及 CPU 和其他系统组件所需的信息。对于企业环境, DDR5 ECC RDIMM 服务器内存 当服务器平台支持时,ECC内存是一个值得评估的重要选项。ECC内存可以检测并纠正某些类型的内存错误,而寄存式DIMM内存则专为兼容的服务器内存架构而设计。 选择时 AI服务器内存, 考虑:系统总内存容量内存通道和支持的数据速率ECC 和注册 DIMM 要求CPU和主板兼容性支持的 DIMM 容量和内存规则数据预处理和并发工作负载的内存需求 不要以为更高的内存频率就能保证更好的应用程序性能。实际性能取决于整个平台、内存配置、工作负载以及支持的运行条件。 例如,即使GPU内存是模型执行期间的主要限制因素,处理大型数据集的AI服务器也可能需要大量的系统内存。 订购前 DDR5 ECC RDIMM请查看服务器制造商的兼容性列表和 CPU 平台支持的内存配置。 NVMe SSD:为活跃的 AI 工作负载提供快速存储存储性能会直接影响 AI 服务器加载模型、访问数据集、写入检查点和处理中间文件的速度。NVMe固态硬盘 由于在兼容平台上实施时可提供低延迟访问和高吞吐量,因此常用于主动式 AI 工作负载。 在选择时 用于人工智能服务器的企业级固态硬盘, 评价:容量和可用硬盘位NVMe 协议和支持的接口顺序和随机读/写性能耐久性评级和预期写入工作负载断电保护和其他企业级功能(如有需要)热管理和持续性能与服务器、背板和存储软件的兼容性高速固态硬盘可以提升数据传输速度,但存储需求却各不相同。例如,反复访问相对较小的模型的工作负载,其存储需求可能与持续处理大型数据集的流水线截然不同。 区分接口规格和实际应用性能也很重要。实际结果取决于队列深度、工作负载模式、硬盘寿命、散热条件和系统配置。 企业级硬盘:面向人工智能数据的大容量存储企业级硬盘 对于容量和每TB成本很重要的大型数据集、历史记录、备份和其他存储工作负载,仍然非常有用。 与固态硬盘 (SSD) 相比,机械硬盘 (HDD) 的随机访问性能通常较低。但是,当应用程序不需要 SSD 级别的延迟时,机械硬盘可以适用于以容量为导向的存储层。 选择时 企业级硬盘, 考虑:所需可用存储容量驱动负载额定值和预期运行条件接口和服务器兼容性冗余和数据保护要求备份和恢复策略功率、冷却和存储密度分层存储架构可以将 NVMe SSD 用于存储频繁访问的数据,将大容量 HDD 用于存储不常用的信息。合适的比例取决于访问模式、可用性要求和预算。 HBA 和 RAID 控制器:管理存储连接主机总线适配器 (HBA) 和 RAID 控制器用途不同,因此正确的选择取决于存储架构。一个 HBA 通常提供主机系统与兼容存储设备之间的连接。 RAID控制器 当控制器和配置支持时,可以提供硬件辅助 RAID 功能。 选择控制器之前,请确认:支持的驱动器接口和协议支持的驱动器数量和可用端口与服务器背板的兼容性所需的 RAID 级别和数据保护功能操作系统和驱动程序支持与预期存储架构的集成对于软件定义存储,某些设计方案中直接访问驱动器可能是更佳选择。而其他部署方案可能需要基于控制器的 RAID 功能。RAID不应被视为备份的替代方案。数据保护需要更全面的策略,该策略应考虑冗余、恢复程序以及硬件或软件故障的后果。 网卡、交换机和光收发器:连接人工智能基础设施当 AI 工作负载在存储系统、服务器和计算节点之间移动大型数据集时,网络性能变得越来越重要。适当的 人工智能数据中心网络 配置取决于流量、节点数量、拓扑结构、协议支持、延迟要求和未来可扩展性。 主要组成部分包括:网络接口卡(NIC): 将服务器连接到网络。以太网交换机: 提供服务器、存储系统和其他网络设备之间的连接。光收发器: 转换电信号和光信号,以建立兼容的网络链路。光纤电缆: 在支持的接口之间传输光信号。对于规模较大的部署,可以根据工作负载需求和基础架构设计考虑使用 100GbE、200GbE、400GbE 或 800GbE 以太网。这些速度并非所有 AI 服务器的通用要求。 在选择时 高速光收发器核实交换机和网卡端口规格、支持的传输速率、传输距离、光纤类型、连接器、波长和互操作性要求。 更高的链路速度并非必然提升所有应用的性能。网络设计必须基于实际流量模式,服务器、交换机、收发器和线缆必须协同工作,形成一个兼容的系统。 电源供应和散热:支持持续性能高性能加速器、CPU、内存和存储设备会产生巨大的电力和散热需求。规划时 AI服务器的电源和散热, 评价:系统总功率需求电源容量和冗余配电和电路容量机箱气流和组件冷却要求机架密度和设施冷却能力工作温度限制持续的工作负荷行为 不要简单地将各个组件的功率额定值相加来确定电源容量,而不考虑系统级要求和制造商的建议。同样,即使某种配置在物理上能够装入服务器机箱,其散热性能也可能不足以支持持续运行。必须对整个配置的电源、气流和散热进行验证。 3. 根据工作负载配置 AI 服务器没有一种硬件规格能够适用于所有人工智能项目。下表总结了不同部署场景的典型优先级。人工智能工作负载主要硬件优先级重要考虑因素人工智能推理GPU 或加速器、GPU 内存、系统 RAM、模型存储模型大小、并发性、延迟、吞吐量模型微调GPU显存、计算能力、系统内存、NVMe固态硬盘数据集大小、检查点、训练方法分布式人工智能训练多加速器、高带宽网络、快速存储互连拓扑、同步、可扩展性RAG 应用CPU、GPU(如有需要)、内存、固态硬盘、网络文档数量、检索架构、响应延迟人工智能数据处理CPU、系统内存、存储吞吐量数据转换、批处理大小、并行处理人工智能数据集和档案企业级固态硬盘和机械硬盘,以及适用的存储控制器容量、访问频率、冗余、保留这些是规划指南,而非固定的物料清单。实际需求会因模型架构、框架、软件栈、数据量、性能目标和部署环境而异。 例如,对延迟要求严格的AI推理服务可能会优先考虑加速器内存和低延迟数据访问。而分布式训练集群则可能更注重加速器互连和网络吞吐量。 在比较各个产品之前,一个有用的起点是记录预期的工作量和性能目标。 4. 如何平衡GPU、内存、存储和网络资源选择合适的组件只是过程的一部分。一个设计良好的 AI服务器硬件配置 还必须防止各组成部分之间出现瓶颈。 找出计算和内存瓶颈首先评估预期模型和工作负载是否适合可用的加速器内存,以及系统 RAM 是否足以满足预处理和支持服务的需求。如果模型或工作负载超出可用资源,则解决方案可能包括更改硬件配置、优化模型、调整工作负载或将处理分配到多个设备上。仅仅购买更强大的GPU并不能解决所有内存或数据管理方面的限制。 使存储性能与数据访问模式相匹配确定工作负载主要需要高顺序吞吐量、频繁随机读取、持续写入还是大容量存储。对于活跃数据集和经常访问的模型文件, NVMe SSD 存储 可能适用。对于大型档案库和访问频率较低的数据集, 企业级硬盘存储 或许能提供更经济的容量等级。应该根据应用程序的需求来衡量存储需求,而不是假设每个 AI 服务器都需要相同的存储配置。 确定何时需要高速网络网络需求取决于服务器之间数据传输量以及分布式工作负载交换信息的频率。对于多节点训练,网络吞吐量和延迟会影响整体效率。而对于独立推理服务器,更简单的网络配置可能就足够了。评估时 400GbE 和 800GbE 网络考虑预期流量、交换机容量、终端支持、收发器兼容性以及升级更广泛基础设施的成本。目标是在不购买工作负载无法有效利用的网络容量的情况下,消除真正的瓶颈。 可扩展性和总体拥有成本规划成本效益高 AI服务器配置 平衡初始购买成本、运营费用和未来扩张成本。考虑总拥有成本(TCO),包括:硬件采购和更换电力和制冷维护和保修存储增长和数据保护网络升级软件和操作要求部署和未来迁移成本如果低成本组件会造成兼容性问题或需要后续进行昂贵的重新设计,那么它可能并非明智之选。反之,如果工作负载无法从中受益,那么选择高端配置可能就没有必要。 5. AI服务器硬件兼容性检查清单购买前 AI服务器组件验证整个系统的兼容性。以下清单可以帮助采购和工程团队降低不必要的配置风险。 GPU和平台兼容性确认服务器型号和主板是否支持GPU。核实物理尺寸、插槽间距和可用的 PCIe 资源。检查电源连接器、功率限制和散热要求。确认是否支持预期数量的加速器。验证相关的固件、驱动程序和软件要求。 服务器内存兼容性确认平台是否需要 ECC RDIMM、其他受支持的内存类型或特定的 DIMM 配置。检查CPU支持的内存容量和数据传输速率。遵循制造商的内存配置规则。核对模块部件号与兼容性列表。确认是否支持混合容量或模块规格(如适用)。 存储和控制器兼容性确认驱动器接口、协议、外形尺寸和容量支持情况。检查服务器背板和可用硬盘位。在适用情况下,请验证 HBA 或 RAID 控制器兼容性。检查操作系统、固件和驱动程序要求。明确冗余、备份和恢复要求。 网络和光兼容性确认支持的网卡和交换机端口速度。检查收发器外形尺寸和接口规格。请核实光纤类型、连接器、波长和传输距离。确认所需交换机和网卡的兼容性要求。评估网络拓扑结构和未来扩展容量。 电源、冷却和部署验证系统总功率需求和供电容量。检查机箱气流和散热限制。确认机架空间、配电和机房冷却情况。审查保修、维修和更换程序。大规模部署前,请对整个配置进行测试。组件的个别规格并不代表其与整个系统完全兼容。如有疑问,请查阅服务器制造商的文档并在订购前获得工程师的确认。 6. 如何制定切实可行的AI服务器采购计划规范的采购流程有助于确保所选硬件能够满足实际运行需求。步骤 1:定义性能和容量需求记录 AI 工作负载、模型大小、数据集大小、预期吞吐量、延迟目标、并发性和预期增长。这些要求为评估 CPU、GPU、内存、存储和网络需求奠定了基础。 步骤二:确认确切的零件编号比较时请使用准确的制造商零件编号。 服务器内存模块固态硬盘 (SSD)、机械硬盘 (HDD)、控制器、网卡 (NIC)、交换机和光收发器。单凭产品名称和主要规格可能无法识别接口、固件、外形尺寸或兼容性方面的重要差异。 步骤 3:验证完整配置核对完整的物料清单与服务器平台、运行环境和预期部署方案是否匹配。对于大型项目,在进行批量采购之前,应先验证样品配置。这有助于在互操作性、性能、散热或部署问题影响整个项目之前发现这些问题。 第四步:评估供应、保修和生命周期要求对于 B2B 硬件采购,请考虑产品可用性、交货时间、保修条款、更换选项和生命周期状态。对于多站点或分阶段部署,零件编号的一致性和供应的连续性可能尤为重要。 第五步:比较总成本和未来扩展成本比较配置时,应考虑其满足性能要求的能力,而不仅仅是其初始组件价格。有效的评估应考虑运营成本、升级途径、支持要求以及更换不兼容组件的潜在费用。 7. 规划人工智能服务器硬件时常见的错误几个反复出现的错误会破坏原本很有前景的基础设施设计。在定义工作负载之前选择GPU: 加速器的选择应遵循模型要求、性能目标和部署限制。低估系统内存: GPU显存和系统内存功能不同。足够的容量才能满足完整的软件和数据处理环境的需求。忽略存储瓶颈: 即使计算资源充足,数据传输速度慢或存储架构不合适也会降低应用程序效率。忽略网络兼容性: 网卡、交换机、光收发器和电缆必须支持预期的接口、速度和传输条件。混用不兼容的组件: 外观相似的内存模块、硬盘和网络产品可能具有不同的兼容性要求。忽略功率和冷却​​: 持续的工作负载会暴露出散热和功耗方面的限制,而这些限制仅从组件列表中是看不出来的。将冗余视为一种完整的备份策略: RAID 和其他冗余机制并不能取代适当的备份和恢复程序。未验证配置就购买: 系统兼容性和工作负载验证比基于单个产品规格的假设更可靠。避免这些错误需要工程、采购、IT运营和硬件供应商之间的协调。 8. 关于人工智能服务器硬件的常见问题构建人工智能服务器需要哪些硬件?典型的 AI服务器 包括中央处理器 (CPU)、系统内存、一个或多个图形处理器 (GPU) 或其他必要的 AI 加速器、存储设备、网络接口、兼容的主板和机箱、电源以及散热系统。具体配置取决于型号、工作负载、性能目标和部署规模。 AI服务器需要多少内存?所需 AI服务器内存容量 这取决于操作系统、模型服务软件、数据预处理、并发应用程序以及工作负载大小。GPU 显存和系统内存是独立的资源,因此两者都需要评估。在确定容量之前,请检查平台限制和应用程序要求。 AI服务器是否必须使用NVMe SSD?NVMe固态硬盘 当工作负载需要低延迟存储和高吞吐量时,例如加载模型、访问活动数据集和写入检查点,NVMe 存储非常有用。然而,并非每个 AI 服务器的每个数据层都需要 NVMe 存储。存储选择应考虑访问模式、容量需求和预算。 AI服务器需要400G还是800G网络?不。 400GbE 和 800GbE 网络 对于某些高带宽人工智能集群来说,这或许是合适的,但并非普遍适用的要求。网络速度的选择应根据流量模式、节点数量、应用需求、终端兼容性以及更广泛的网络架构而定。 如何检查AI服务器硬件兼容性?首先查阅服务器制造商的文档和支持的组件列表。确认具体的部件编号、内存规格、驱动器接口、PCIe 要求、网卡和收发器兼容性、功率限制以及散热限制。批量采购前,务必验证完整的配置。 我应该为人工智能存储选择企业级固态硬盘 (SSD) 还是机械硬盘 (HDD)?选择 企业级固态硬盘 当低延迟、高 IOPS 或快速数据访问至关重要时,请考虑以下因素。 企业级硬盘 对于大容量数据集、归档数据以及其他能够容忍较高访问延迟的工作负载,许多环境都能从结合两种存储类型的分层设计中获益。 批量采购AI服务器组件时应该考虑哪些因素?评估订单中所有零件的准确编号、兼容性、数量、供货情况、交货周期、保修条款、生命周期状态以及一致性。对于复杂项目,在进行批量采购前,请索取经审核的物料清单并验证样品配置。 结论:围绕工作负载构建人工智能服务器成功的 AI服务器硬件规划 首先要考虑的是工作负载,而不是单个产品的规格。GPU 和 CPU 资源、服务器内存、存储、网络、电源供应和散热必须协同工作,才能满足项目的性能、可靠性和预算要求。结构化的 AI服务器硬件检查清单 帮助团队识别兼容性风险、避免不必要的支出并规划未来发展。通过在购买前验证完整的配置,企业可以就其人工智能基础设施做出更明智的决策。对于采购企业计算和网络组件的组织而言,AILINK100 可以作为探索相关硬件类别和产品选项的起点。在索取报价之前,请准备好您的服务器型号、预期工作负载、所需规格、预计数量和交付要求。 需要帮忙采购服务器硬件吗? 联系 AILINK100 团队,讨论您的组件需求,并确定合适的产品以进行进一步的兼容性审查和采购计划。
  • 为什么DDR5-5600 ECC RDIMM是企业级服务器的理想选择?
    为什么DDR5-5600 ECC RDIMM是企业级服务器的理想选择?
    September 28, 2026
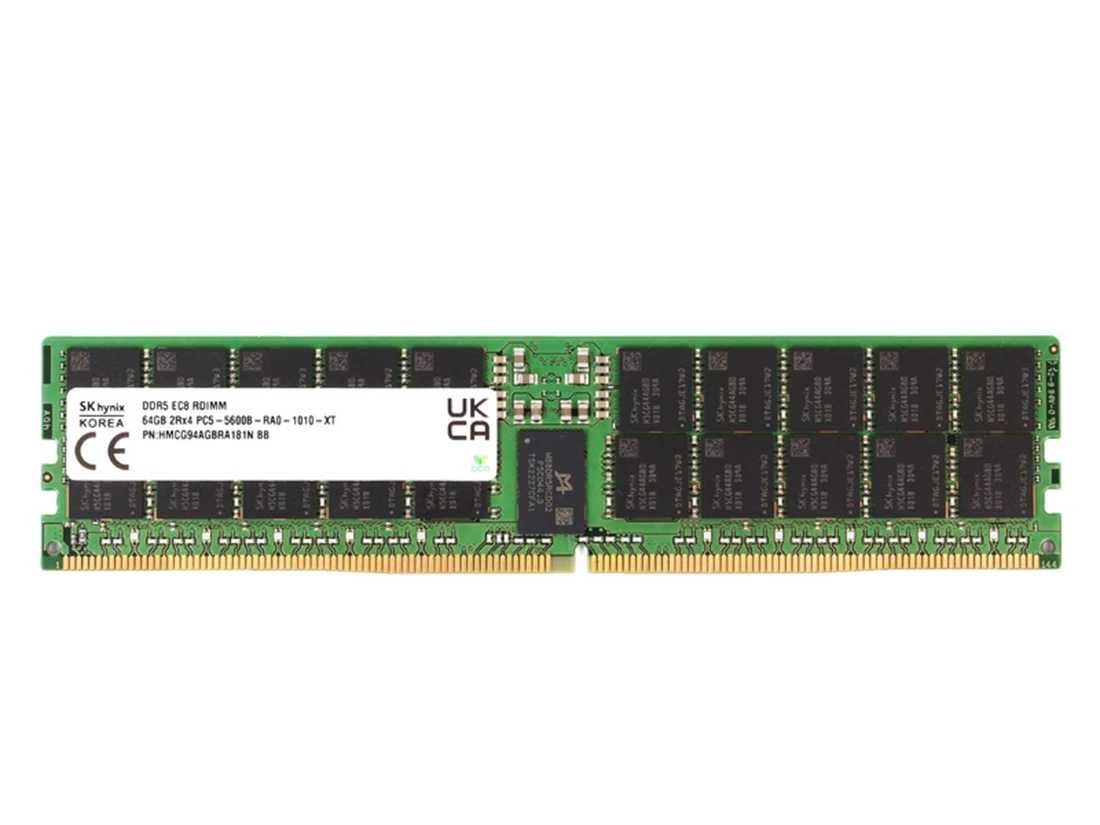
    企业级服务器需要兼顾内存速度、可靠性和可扩展性。DDR5-5600 ECC RDIMM 内存条完美融合了这三者。它提供 5600MHz (PC5-44800) 的高速性能,足以应对高负载需求。内置 ECC 纠错功能可主动纠正错误,保护关键数据。寄存式设计确保多个模块之间的信号完整性。这款 DDR5 ECC 寄存式 RDIMM 内存条在虚拟化、数据库和高性能计算 (HPC) 等领域表现卓越。作为企业级服务器内存,它能够有效消除性能瓶颈。DDR5 ECC 寄存式 RDIMM 架构支持高内存配置。这款 DDR5-5600MHz ECC 寄存式 RDIMM 内存条是可靠的 DDR5 ECC 企业级服务器内存之选。 SK海力士DDR5-5600内存 这是一款完整的解决方案。您只需一条 DDR5 RDIMM 内存条,即可获得可靠性、高性能和可扩展性。这款企业级服务器内存可确保基础架构平稳运行。要点总结ECC纠错技术能够自动修复单比特内存错误,防止系统崩溃,保障数据安全。该注册设计可降低内存控制器的负载。您的服务器可支持更多内存模块,并提供稳定的信号。DDR5-5600 内存以 1.1V 的电压即可提供 5600MHz 的高速运行。兼具高性能和节能优势。此内存适用于 Intel Xeon 和 AMD EPYC 服务器。请务必查看服务器的 QVL(合格供应商列表)以确保完全兼容。片上温度传感器可管理温度并调整刷新率。即使在高负载下,您的服务器也能保持稳定运行。DDR5-5600 ECC RDIMM 在服务器可靠性中的作用ECC纠错能力DDR5-5600 ECC RDIMM 内存条为企业级服务器提供主动纠错功能。该模块中的 ECC(纠错码)可自动纠正单比特内存错误。这种纠错机制可防止关键任务应用程序中出现意外的系统崩溃和数据损坏。数据库事务或金融处理等工作负载需要依靠这种保护机制。单个比特的错误就可能导致代价高昂的停机。ECC 内存通过在错误影响操作之前将其修复,从而消除这种风险。标准 ECC DIMM 实现了 SECDED(单错误纠正,双错误检测),它可以纠正任何单比特错误,并能检测双比特错误,但不能纠正双比特错误。对于企业级环境而言,这种全面的 ECC 支持意味着您将获得强大的保护。该模块能够静默地捕获并纠正大多数内存错误。此功能无需人工干预即可维护数据完整性。您可以信赖您的 DDR5 ECC 内存,它能够处理那些原本会导致数据损坏或服务中断的错误。SK 海力士 DDR5-5600 内存采用了这种先进的 ECC 技术。作为一款 DDR5 ECC 注册式 RDIMM 内存模块,它提供卓越的错误保护。您可以获得久经考验的可靠性,满足您最苛刻的应用需求。信号完整性注册设计除了纠错功能外,这款 DDR5 ECC 注册式 RDIMM 的注册设计还增强了信号完整性。当服务器安装大量内存模块时,电气负载会增加。RDIMM 架构可以降低内存控制器的负载。这种设计即使在高容量配置下也能确保稳定运行。服务器的内存控制器向内存模块发送命令信号和地址信号。在DDR5 RDIMM内存条上,模块上的寄存器(寄存器时钟驱动器,RCD)首先接收这些信号。这些信号并非直接发送到每个DRAM芯片。寄存器缓冲命令信号和地址信号,然后将它们重新发送到 DRAM 设备。由于内存控制器只驱动寄存器输入而不是整个 DRAM 负载,因此控制器上的直接电负载显著降低。负载降低可提高信号完整性,并使系统能够支持每个通道更多的内存模块和更高的总容量。 RCD还能提升高频信号完整性。在DDR5中,RCD每侧输出四个时钟信号,而非两个。每组DRAM芯片都接收独立的时钟信号。这种设计降低了噪声,提高了5600 MT/s的可靠性。DDR5 RCD技术的数据速率比上一代提升了17%。此外,它还具有更低的延迟和功耗,并优化了时序参数,从而提高了模块裕量。特征DDR4DDR5每边输出时钟24独立时钟信号No是的信号完整性改进有限的增强型RCD 作为关键的控制平面芯片,负责将命令/地址信号和时钟信号分配给 DRAM 设备。您的服务器将受益于卓越的命令/地址和时钟信号完整性。这种 ECC 注册式 RDIMM 设计确保您的 ECC 服务器内存即使在高负载下也能可靠运行。作为一款 DDR5 ECC 注册式 RDIMM 模块,该内存可为企业应用提供所需的稳定性。这些 ECC 内存模块在严苛的环境下也能提供始终如一的性能。您可以信赖它。 ecc rdimm 内存 为了长期表现。 DDR5-5600MHz ECC Registered RDIMM 内存可提升性能 提高企业工作负载的带宽DDR5-5600 ECC RDIMM 内存条提供 5600 MT/s 的数据传输速率,也称为 PC5-44800。这种 5600MHz (PC5-44800) 的高速性能可消除高要求企业工作负载中的瓶颈。您可以获得更快的数据库查询、更流畅的云计算操作以及更快速的 AI 推理结果。DDR5 ECC 注册式 RDIMM 内存条模块能够处理海量数据传输,而不会降低关键应用程序的运行速度。 这款 DDR5 ECC 注册式服务器内存模块提供 5600MHz (PC5-44800) 的带宽性能,可显著提升服务器的性能。在虚拟化环境中,每个虚拟机都会争用内存资源。这款 DDR5-5600MHz ECC 注册式 RDIMM 内存条提供充足的带宽,确保所有虚拟机流畅运行。即使在高负载下,您的虚拟机管理程序也能保持稳定运行。 高性能计算 (HPC) 工作负载将从这种带宽中获益匪浅。科学模拟、金融建模和基因组测序都需要快速的数据传输。DDR5 ECC 服务器内存确保您的处理器无需等待数据。存储系统也能从这种速度中受益。您可以在整个基础架构中实现更快的读写操作。 DDR5 RDIMM 采用 CL46 CAS 延迟。这种时序规格兼顾了企业级应用的速度和响应能力。SK 海力士 DDR5-5600 内存可为您的数据中心带来这些性能提升。您可以放心地将此内存部署到数据库服务器、云平台和 AI 基础设施中。 1.1V低功耗运行在企业数据中心,电源效率至关重要。DDR5-5600MHz ECC Registered RDIMM 内存条仅需 1.1V 电压即可运行。如此低的电压显著降低了发热量,从而减少了冷却系统的运行负荷,降低了能源成本,最终提升了整个数据中心的电源利用率。 64GB 的内存密度和 2Rx4 通道配置可实现经济高效的扩展。您只需在服务器上安装更少的内存模块,即可获得更高的总容量。这款高容量服务器内存模块可减少占用空间并简化维护。每个 RDIMM 都能提供充足的内存,而不会占用过多的插槽空间。范围规格数据速率5600 吨/秒 (PC5-44800)工作电压1.1伏密度64GB排名配置2Rx4CAS 延迟CL46ECC寄存器式RDIMM设计也有助于节能。寄存器可缓冲命令和地址信号,从而降低内存控制器的电负载。您的系统在保持信号完整性的同时,还能降低功耗。这种ECC寄存器式RDIMM架构对于大容量服务器内存模块部署至关重要。 虚拟化环境、高性能计算集群和存储系统都能从这种组合中受益。您将获得 DDR5 技术的高性能和 ECC 纠错的可靠性。DDR5 ECC 注册式 RDIMM 内存模块能够满足您最苛刻的工作负载需求。您的数据中心将高效运行,同时实现最大吞吐量。 ECC RDIMM 内存如何验证数据完整性严格的企业级验证企业级服务器持续运行,因此您的 ECC RDIMM 内存必须能够承受高强度的运行。SK 海力士 DDR5-5600 内存经过服务器级压力测试,模拟真实数据中心环境。这些测试包括长时间老化测试、极端温度测试和持续数据流量测试。目标很简单:证明每个 DDR5 ECC 注册式 RDIMM 内存模块都能全天候稳定运行,不会出现故障。 JEDEC 合规性是此验证的基础。JEDEC DDR5 RDIMM 通用标准涵盖了 288 位、1.1V 寄存式 DDR5 DIMM 的电气和机械要求。但是,仅凭 JEDEC 合规性并不能保证与所有服务器兼容。您仍应验证以下几个因素:服务器验证取决于 CPU 代数、内存控制器、BIOS、每通道 DIMM 数量、等级组织和供应商资质。请将模块部件号与您的主板或服务器供应商的合格供应商列表进行核对。选择经过验证符合 JEDEC 标准并列于服务器供应商 QVL 中的模块。可能仍需根据服务器型号的内存支持矩阵进行手动验证。这种分层式设计确保您的 DDR5 ECC 内存能够在您的特定平台上提供完整的 ECC 支持。DDR5 ECC 寄存式 RDIMM 架构符合严格的标准,SK 海力士的质量控制流程也确保每个模块都已做好企业级部署的准备。 片上热管理功能繁重的工作负载会在服务器内部产生大量热量。DDR5 ECC Registered RDIMM 内存模块通过片上温度传感器解决了这一难题。这些传感器实时监测 DRAM 芯片的温度状况。当温度升高时,模块会触发自适应刷新率。这种响应机制能够在不牺牲性能的前提下,在高负载下保持服务器的稳定性。 这款 RDIMM 内存条的 1.1V 工作电压相比更高电压的同类产品,已经显著降低了发热量。结合片上散热管理,您的 ECC 服务器内存始终保持在安全的工作范围内。即使在高峰期,您也能获得稳定的 5600 MT/s 性能。这种智能散热设计能够保护您的投资并延长内存条的使用寿命。由于 RDIMM 内存条能够自主管理散热,因此可以可靠运行。ECC 注册式 RDIMM 设计在芯片级集成了这些安全保护措施。您将获得能够主动保护数据和硬件的 ECC 内存。 DDR5 RDIMM 与企业平台的兼容性针对英特尔和AMD处理器进行了优化您选择的服务器平台决定了此内存能否全速运行。DDR5-5600 ECC RDIMM 内存条可与第四代和第五代英特尔® 至强® 可扩展处理器无缝集成。AMD EPYC 9004 系列平台也验证了此内存模块支持注册式 ECC 功能。根据产品信息,SK 海力士 DDR5-5600 内存已通过验证,适用于支持注册式 ECC 内存的服务器平台,包括 AMD EPYC 9004 系列平台。您将获得两大主流处理器系列的广泛生态系统支持。 平台验证不仅限于插槽兼容性。每个处理器内部的内存控制器负责管理时序、电压和刷新行为。英特尔和AMD均按照JEDEC DDR5标准设计这些控制器。您的DDR5 ECC寄存式RDIMM内存模块也遵循这些标准。这种一致性确保了从首次启动开始即可稳定运行。您可以将此DDR5 ECC服务器内存部署到各种混合环境中,而无需进行任何平台特定的调优。 记忆人群指南高容量安装需要仔细规划,然后再安装内存模块。首先检查您的 BIOS 版本。较旧的固件可能无法识别 64GB 容量或 2Rx4 通道配置。请更新到服务器供应商提供的最新版本。此步骤可防止启动失败,并确保您的系统应用正确的时序参数以支持 5600 MT/s 的运行速度。 请遵循适用于您主板的正确内存插槽安装规则。这些规则规定了插槽顺序、通道平衡和内存等级分布。如果插槽顺序错误,可能会导致内存速度降低,甚至完全无法启动。购买前,请查阅服务器供应商的合格供应商列表 (QVL)。该列表建议您检查主板的 QVL 以确保完全兼容。此验证可确保您的 ECC 注册 RDIMM 内存模块符合供应商测试要求。您可以避免部署过程中出现兼容性问题,并确保每个通道都保持完整的 ECC 保护。  您的企业服务器需要各方面性能卓越的内存。DDR5-5600 ECC RDIMM 内存条集 ECC 内存的可靠性、寄存式设计、5600 MT/s 的读写速度、1.1V 的低功耗以及广泛的平台兼容性于一体。这款 DDR5 ECC 寄存式 RDIMM 内存条并非单一功能组件,而是面向现代数据中心的均衡解决方案。您只需一个模块即可获得更高的带宽、更佳的能效和更强的可扩展性。寄存式架构可保护您的关键工作负载。SK 海力士 DDR5-5600 内存满足这些需求。作为 IT 决策者,请将这款 DDR5 ECC 内存作为新服务器部署的标准配置。它能确保您立即获得性能提升,并实现长期的基础架构可扩展性。选择 ECC 服务器内存,助力您的业务增长。 常问问题DDR5内存与标准RAM有何区别?该模块将ECC纠错与寄存器设计相结合,从而确保数据完整性和信号稳定性。标准RAM则不具备这两项特性。ECC如何保护您的企业数据?ECC(纠错码)可自动纠正单比特内存错误,防止系统崩溃和数据损坏,确保您的关键应用程序不间断运行。这款 64GB 内存条有哪些技术规格?SK海力士DDR5-5600内存的主要技术规格包括5600MHz频率、64GB容量和2Rx4通道。该内存模块工作电压为1.1V,时序延迟为CL46。ECC 注册 RDIMM 如何提高服务器稳定性?ECC 注册式 RDIMM 架构通过 RCD 芯片缓冲信号,从而降低内存控制器的电负载。您的服务器支持更多模块。哪些处理器支持这款DDR5内存条?这款 DDR5 内存模块支持 Intel Xeon Scalable 和 AMD EPYC 处理器。这两个平台均支持注册式 ECC 操作。您的部署可在混合服务器集群中正常运行。
  • 如何为人工智能数据中心网络选择高速光收发器
    如何为人工智能数据中心网络选择高速光收发器
    September 20, 2026
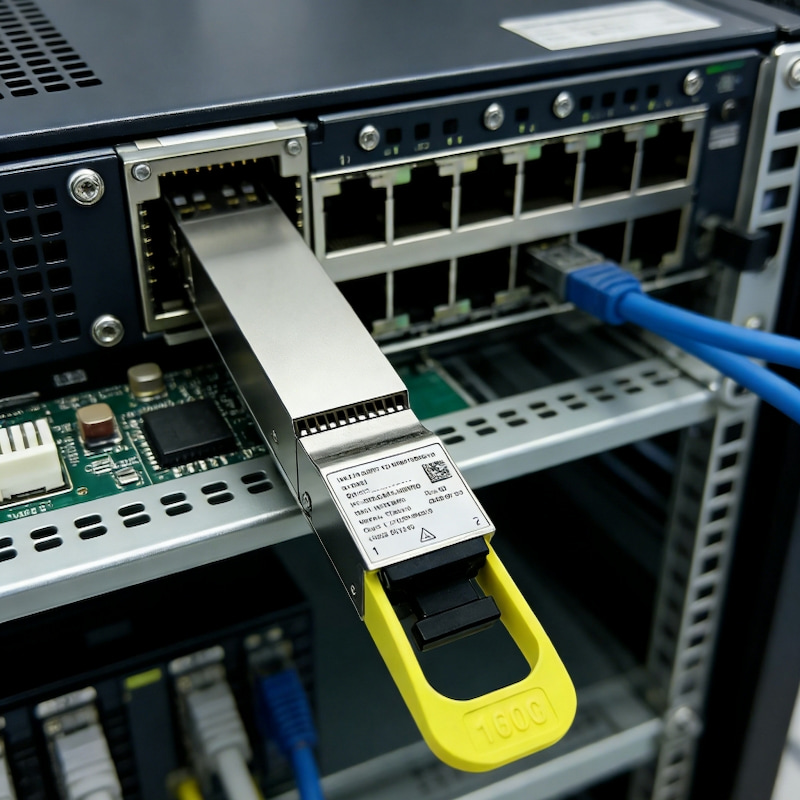
    选择 高速光收发器 通过匹配以下五个要素来优化您的网络架构:速度、传输距离、光纤类型、外形尺寸和交换机兼容性。速度最快的端口往往并非最佳选择。加速计算工作负载更看重低延迟、高端口密度和可预测的功耗预算。 先考虑工作负载,然后再逐步扩展。这种顺序使得收发器的选择具有可重复性,并且能够将光收发器的速度与实际链路距离挂钩,而不是与市场宣传挂钩。每增加一个收发器,机架的电源、散热和布线基础设施都会发生变化。 尽早规划人口密度和迁移方案。可靠的合作伙伴,例如 X REACH 有限公司 提供配套的光学器件和线缆,因此随着规模的扩大,您的基础设施将保持一致。 要点总结收发器速度应根据端口用途而定,而非追求最高速度值。接入链路使用 100G,主干链路使用 400G,上行链路使用 800G。对于新建人工智能系统,请选择单模光纤。这样可以减少四倍的光纤数量,并支持无缝升级到 800G。部署前,请对每个模块进行分线测试。固件限制是造成大多数故障的原因,尤其是在 800G 拆分为 4x100G 的情况下。计算每个机架的每个端口的功耗。800G 模块会增加 14-18W 的功耗,使热负荷增加 1.5 到 2 倍。 S高速人工智能数据中心光收发器的分级100G、400G 和 800G 的比较每个速度层级在网络架构中都扮演着不同的角色。在叶节点部署 100G 带宽,用于服务器访问和管理链路。在脊节点部署 400G 带宽,用于机架内 GPU 互连。预留 800G 带宽用于脊节点上行链路和承载聚合流量的 pod 间链路。 最佳选择取决于工作负载、端口类型和链路距离。单凭速度本身意义不大。传输距离为 500 米的 400G 端口与传输距离为 2 公里的端口所解决的问题截然不同。收发器光纤/连接器最大延伸距离400G-DR4单模/MPO-12500米400G-FR4单模/双工液晶2公里这个距离很重要。行内和相邻行布线时,选择 DR4 模块。链路跨越大厅时,选择 FR4 模块。光收发器的速度在两种模块中保持不变,但传输距离决定了哪种模块更适合您的布局。 人工智能面料为何迈向 800G 和 1.6T 时代AI训练改变了带宽计算方式。一次GPT级别的训练运行就能使100G链路的带宽饱和数千次。NVIDIA GPU集群将超过10万个加速器连接在一个架构中。每个GPU需要400-800Gbps的互连带宽。这样的集群总容量可达每秒80PB。目前人工智能训练需要 800G 内存,到 2026 年需要 1.6T 内存,而 400G 内存就足以满足一般云工作负载的需求。仅梯度同步所需的参数服务器通信就需要 3–5 Tb/s 的带宽。所有归约操作都需要同时高速访问每个节点。检查点存储和数据管道馈送也会持续增加负载。 高带宽光收发器 通过增加每个模块的通道数来缓解这种压力。 1.6T 的推出遵循清晰的顺序:2025–2026 年:早期部署和容量提升,集中在 AI 训练集群和高容量主干层。2026-2027 年:AI 架构得到更广泛的应用,混合 400G/800G/1.6T 环境仍然很常见。2027 年及以后:路线图指向 3.2T 模块,OSFP-XD 将面向更高的通道密度。厂商的积极布局印证了这一转变。Marvell 于 2026 年 3 月开始批量出货其 3nm Ara 1.6T PAM4 DSP。思科发布了 Silicon One G300 系统,该系统配备 64 个端口,支持 1.6T 运算。Arista 也发布了 7060XE7 系列的 64 端口 1.6T 平台。早期 1.6T 部署的定价较高,单价超过 3000 美元。 标准仍落后于硬件。截至2026年7月,IEEE P802.3dj仍处于草案3.1阶段,最终版本尚未发布。因此,您的采购规范必须区分“按照当前P802.3dj草案设计”和“符合已发布的最终标准”。OSFP MSA修订版5.1包含了OSFP1600的相关规定,而OIF已于2026年5月发布了CMIS 5.4。 根据这个节奏规划您的基础设施。为当前的 AI 集群购买 800G 带宽,并确认您的交换机芯片和线缆支持未来升级到 1.6T。这种方法可以保护您的基础设施投资,并在网络流量增长时保持效率。 数据中心网络的覆盖范围、光纤和光收发器SR、DR、FR 和 LR 拓展课程传输距离等级决定了链路的传输距离。在 400G 模式下,四种常见的传输距离等级覆盖的范围差异很大。收发器类型最大支持距离纤维/中等400G SR8100米OM3 多模(MPO-16,850 nm)400G DR4500米单模(MPO-12,1310 nm)400G FR42公里单模(双工LC、CWDM)400G LR410公里单模(双工LC、CWDM)SR8适用于机架内100米以内的线路。DR4用于单个机房内的叶脊链路。FR4和LR4适用于更长的线路,包括楼宇间的跨度。 远距离光收发器 例如,LR4模块可以在校园内承载交通流量而无需再生。 单模与多模以及MPO架构单模光纤如今已成为新型人工智能网络建设的主流选择。SR8 400G 版本采用 16 根光纤,通过 MPO-16 连接器传输。DR4 版本则采用 MPO-12 连接器,单模光纤传输距离可达 500 米。光纤数量的减少降低了光缆体积,并简化了 MPO 架构。 成本也是影响决策的因素之一。一个 400G SR8 模块的价格约为 219 美元,而一个 400G DR4 模块的价格约为 549 美元。就短期链路而言,多模光纤在价格上更具优势。但如果规划未来扩展,单模光纤则更具优势。对于 100G 部署,分界点大约在 200-250 米左右。超过这个距离,从技术角度来看,单模光纤不仅成为必需,而且随着时间的推移,其成本也更低。 收发器的选择决定了拓扑结构的可扩展性。单模光纤可以通过增加通道数来升级到 800G DR8。多模光纤如果没有新的 MPO-16 链路,则无法实现纯净的 800G 路径。一次性规划好光纤基础设施,即可避免日后代价高昂的重新布线工程。 外形尺寸和交换机兼容性QSFP-DD、OSFP 和 QSFP112封装尺寸决定了面板上可容纳的带宽以及每个端口产生的热量。QSFP-DD 是 400G 模块的常用封装尺寸,而 OSFP 则面向 800G 和 1.6T,其支持在 OSFP MSA 5.1 版中定义。QSFP112 是另一种 400G 封装尺寸,使用更少但速度更快的通道。在最终确定封装尺寸之前,请务必将其与您的交换机 ASIC 和散热设计相匹配。 端口、分支和互操作性检查分线器可以将一个 400G 端口拆分为四个 100G 链路。这种模式适用于脊叶式扇出、GPU 集群扩展以及从 100G 到 400G 的逐步升级。您需要合适的交换机端口配置、MPO 分线器线束、兼容的远程光模块以及精确的通道映射。 请务必对照交换机厂商提供的兼容性矩阵,验证每个模块与您的 SKU 和软件版本完全匹配。确认功率等级,并检查交换机固件和收发器的 CMIS 版本是否一致。建议先在实验室环境中测试分路模式。低成本模块通常在原生 400G 模式下运行良好,但在分路模式下由于固件或通道映射的限制而出现故障。兼容性因供应商和模块而异。选择收发器时,应将其视为兼容性测试,而非速度竞赛,这样您的AI架构才能在第一次尝试时就顺利连接。 人工智能网络中的电源、冷却和可靠性每个端口的功率和热预算更高的光收发器速度会增加每个模块的发热量。800G 模块比 400G 模块消耗更多功率,这会影响您的机架预算。虽然 800G 的传输效率更高,推动了 AI 集群的迁移,但每个模块仍然会产生热量,您必须将其排出。 冷却能力目前限制了机架的密度。单端口功率从 400G 提升到 800G 会增加机架的热负荷,因此为 400G 设计的冷却系统可能无法满足 800G 的需求。 粉尘、高温和机械应力风险AI机架的功率密度极高,GPU温度会长时间保持在高位。您的GPU集群网络光收发器必须能够承受这种高温。端口侧排气设计会增加热应力,不稳定的气流会降低链路裕量。温度效应对光学性能的影响可靠性影响高温降低的光功率输出下部链路裕度稳定性温度波动信号波动和抖动增加更高的误码率风险稳定的热控制稳定的光学性能延长模块寿命热量也会导致激光波长发生偏移。在波分复用(WDM)系统中,这种漂移可能会使信号超出接收机滤波器的窗口范围。误码率(BER)随即升高,链路甚至可能完全断开。 灰尘和机械应力会加剧问题。受污染的MPO端面会散射光线并切割边缘。反复插拔会磨损连接器插芯。高质量的光学元件可减少灰尘、热量和应力引起的故障,从而在多年的使用过程中保护您的基础设施和性能。 甄选框架及常见错误逐步选择顺序可重复的订购流程能确保收发器选择基于您的网络架构而非规格表。请按以下步骤操作:明确工作负载。确定链路是用于 GPU 互连、主干链路聚合还是存储。AI 训练集群倾向于使用短距离、高密度、低延迟的链路。设置速度。带宽应与端口功能相匹配,而不是与可用最大值相匹配。确定传输距离。测量实际光纤长度。多模光纤传输距离不超过 100 米时选择 SR8,单模光纤传输距离不超过 500 米时选择 DR8,单模光纤传输距离不超过 2 公里时选择 FR4。确认光纤线路。多模光纤和单模光纤之间的切换会大幅增加部署成本。选择外形尺寸。确认交换机ASIC带宽是否支持OSFP或OSFP-XD。验证兼容性。检查供应商列表,确认EEPROM编码,并在大规模部署前在实际硬件上进行测试。控制电源和散热预算。将机架中每个端口的单端口功率相加。制定备件计划。每种光学元件都应储备适量的备件。此方案可保障您的基础设施预算和部署进度。 阻碍人工智能部署的陷阱报价中最便宜的模块往往在其整个生命周期内成本最高。例如,为 1 公里链路购买 LR4 模块,不仅浪费了网络实际用不到的距离,还增加了每个端口的功耗。反之亦然。在 700 到 1000 米的链路上使用 DR4 模块,一旦裕量耗尽,就可能迫使重新设计或紧急更换。功耗会加剧这种情况。即使功率只增加一点点,也会在数百个端口上累积成倍增长。 布线错误同样常见。请注意以下几点:MPO连接器类型错误。SR8需要MPO-16,DR4需要MPO-12。极性不匹配。匹配APC和UPC连接器。连接器性别错误。收发器使用公头MPO连接器,而跳线必须使用母头连接器。800G链路的分支布线不规范。长度规划不佳。供应风险同样不容忽视。如果设计依赖于单一供应商提供的某个编码模块,一旦DSP、EML激光器或封装产能紧张,整个生产流程就可能停滞。多供应商认证和明确的备件策略可以降低这种风险。停机成本使这些陷阱变得触手可及。一个配备低质量光学器件的1000 GPU集群可能会遭受重大损失。 长距离数据中心光收发器和GPU集群网络光收发器各自具有不同的故障模式。高带宽数据中心光收发器需要精心规划。应将收发器选择视为生命周期决策。您的基础设施、性能和效率都取决于此。  将速度、传输距离、光纤类型、外形尺寸、兼容性和运行适应性与您的网络架构相匹配。这一原则确保高速人工智能数据中心光收发器能够满足实际工作负载需求。 人工智能网络需要提前规划。购买前,应考虑密度、功耗和迁移路径等因素。一次性购买会增加整个基础设施的成本和风险。 请务必对照交换机供应商的兼容性列表验证每个光模块。选择可靠的合作伙伴,以确保质量和供货的稳定性。周密的规划能够保护您的基础设施,并在扩展过程中保持网络的高效运行。 常问问题对于人工智能面料,首先应该选择哪种速度?首先考虑端口用途。服务器接入使用 100G 端口,脊梁链路和机架内 GPU 链路使用 400G 端口,脊梁链路上行链路和 pod 间链路使用 800G 端口。带宽应根据工作负载进行匹配,而不是一味追求数据手册上的最高数值。如何选择SR8、DR4、FR4和LR4?测量实际光纤长度。SR8 支持多模光纤链路,传输距离可达 100 米。DR4 支持单模光纤链路,传输距离可达 500 米。FR4 和 LR4 的传输距离分别可达 2 公里和 10 公里。LR4 等长距离数据中心光收发器无需再生即可承载园区链路。为什么单模光纤在新人工智能建设中占据主导地位?由于单模光纤传输距离更远、带宽余量更大,因此在新人工智能系统中占据主导地位。400G DR4 使用 MPO-12 连接器,而 SR8 使用 MPO-16 连接器,因此单模光纤可以减少线缆体积。此外,单模光纤还可以无缝升级到 800G DR8。什么原因最容易导致 800G 分支链路中断?固件和通道映射限制是造成大多数故障的原因。一个在原生 400G 模式下运行良好的模块,在 4x100G 分线模式下可能会出现故障。在扩展之前,请确认交换机端口配置文件,使用正确的 MPO 线束,并在实验室环境中测试分线模式。每个端口会增加多少功率和热量?800G 模块比 400G 模块功耗更高,因此从 400G 升级到 800G 会增加机架的热负荷。将每个端口的单端口功耗相加,然后确认您的散热设计能够应对总功耗。为什么要制定备件计划和多供应商认证?GPU 停机代价高昂。一个拥有 1000 个 GPU 且光模块故障率较高的集群可能会损失数小时。多供应商认证和明确的备用资源池可以保护您的基础设施免受供应短缺和单一供应商风险的影响。周密的规划能够确保您的基础设施在扩展过程中保持高效运行。
  • 为什么 RTX 5090 是游戏和人工智能的最佳 GPU
    为什么 RTX 5090 是游戏和人工智能的最佳 GPU
    September 17, 2026
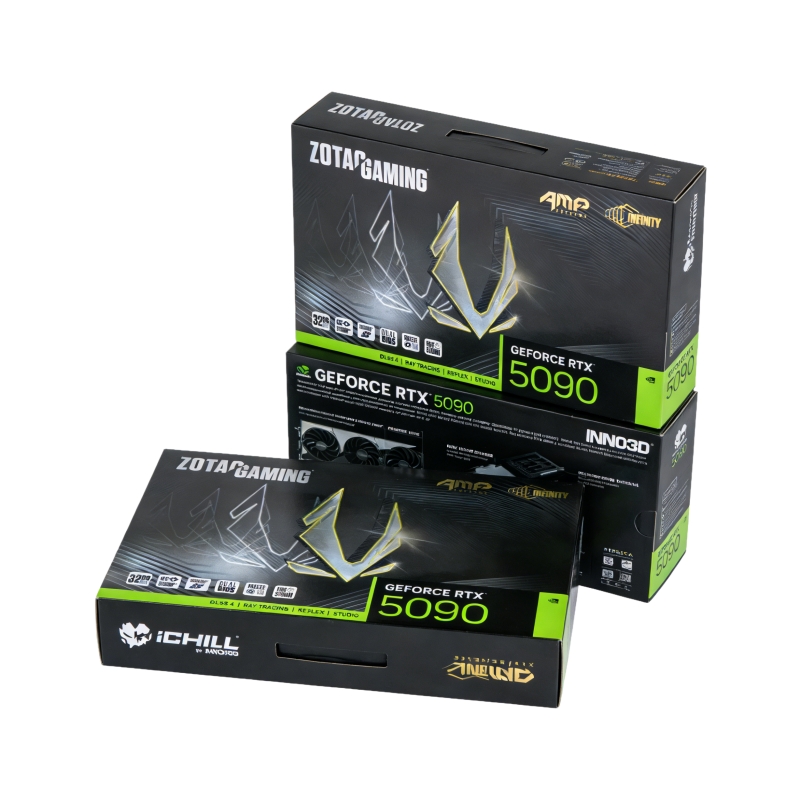
    RTX 5090 是目前游戏和 AI 领域最优秀的 GPU。它能为你带来无与伦比的强大性能。 NVIDIA GeForce RTX 5090没有其他GPU能与之匹敌。这款游戏旗舰显卡拥有三大核心优势。首先,21,760个CUDA核心带来的强大计算能力,显著提升了帧率。其次,DLSS 4.5结合多帧生成技术,根据NVIDIA基准测试,可将4K路径追踪游戏的性能提升高达35%。第三,32GB GDDR7显存加速了模型训练。RTX 5090还配备了PCIe 5.0 x16和DisplayPort 2.1接口。如此卓越的性能树立了新的标杆。基准测试、规格参数以及对比测试都印证了所有说法。这款GPU重新定义了显卡的性能极限,没有任何其他GPU能够与之匹敌。 要点总结RTX 5090 拥有 21,760 个 CUDA 核心和 DLSS 4.5,在游戏领域占据主导地位,可提供流畅的 4K 和 8K 游戏体验。其 680 个 Tensor Core 和 32GB GDDR7 内存可加速 AI 训练和推理,轻松处理大型模型。与 RTX 4090 相比,它的内存带宽提高了 78%,从而加快了模型训练和 8K 视频编辑等数据密集型任务的速度。由于该显卡功耗高达 575W,因此需要 950W 的电源,所以请准备一个功率强劲的电源。如果您对游戏、人工智能或专业工作有极致性能要求,请升级;如果您玩的是 1080p 游戏,则无需升级。RTX 5090 游戏性能  原始功率和基准测试RTX 5090 的每一帧渲染都由 Blackwell 架构驱动。其核心包含 21,760 个 CUDA 核心和 170 个第四代 RT 核心。这些数字比上一代旗舰产品提升了约 33%。下表列出了直接对比。规格RTX 5090RTX 4090CUDA 核心21,76016,384RT核心170128硬件性能的显著提升直接体现在游戏基准测试中。在专注于光线追踪的 3DMark Port Royal 测试中,RTX 5090 搭配 Intel Core i9-14900K 处理器取得了 46,823 分的成绩。而搭配 AMD Ryzen 9 9950X3D 处理器的测试则达到了 46,808 分。在 4K 分辨率的 DirectX 12 基准测试 Time Spy Extreme 中,RTX 5090 搭配 Ryzen 9 9950X3D 处理器取得了 26,815 分的成绩。这些成绩使这款 GPU 跻身名人堂排行榜前列。它能够流畅运行所有现代游戏,即使在 8K 分辨率下,也能在高要求引擎中保持流畅的帧率。RTX 5090 的规格包括 PCIe 5.0 x16,可实现超低延迟。DisplayPort 2.1 和 HDMI 2.1 输出接口支持高刷新率的 4K 和 8K 显示器。这种连接方式可确保您的显示器永远不会成为图形处理器的瓶颈。 光线追踪和 DLSS 4.5这款GPU的光线追踪性能达到了新的高度。170个第四代RT核心能够以惊人的效率处理实时路径追踪。在支持的游戏中,您可以体验到逼真的光照、阴影和反射效果。RTX 5090将这套硬件与DLSS 4.5和多帧生成技术相结合。这项技术会在渲染帧之间插入额外的帧,从而显著提升高要求游戏的帧率。 英伟达 DLSS 4.5 的设计旨在兼容众多游戏。您可以在设置中启用它,在不显著降低视觉效果的前提下提升性能。强大的 RT 硬件与 DLSS 的结合,使 4K 路径追踪成为一种切实可行的选择。 GeForce RTX 5090 也受益于其高显存带宽。其 32GB GDDR7 显存采用 512 位总线,可提供高达 1792 GB/s 的带宽。如此高的显存带宽能够快速地为 GPU 提供数据。高显存带宽对于处理大型纹理和复杂场景至关重要。正是由于这种显存带宽优势,该显卡才能保持稳定的帧输出。对于竞技游戏而言,PCIe 5.0 x16 进一步降低了延迟。在快节奏的游戏中,您可以更快地做出反应。RTX 5090 提供无与伦比的游戏体验。其在光线追踪游戏中的实际基准测试性能树立了新的标杆。每一项基准测试都证实了该显卡在游戏领域的统治地位。 NVIDIA AI 性能和工作负载  Tensor Core 和 32GB GDDR7RTX 5090 凭借其第五代 Tensor Core 彻底改变了 AI 工作负载。这些专用单元加速了每个神经网络核心的矩阵运算。您将获得 32GB GDDR7显存采用512位总线,这种配置无需交换到系统内存即可处理海量数据集。显存带宽高达1792 GB/s,相比之下,RTX 4090的显存带宽为1008 GB/s,提升幅度高达78%。在训练大型语言模型或处理高分辨率图像时,这一优势至关重要。GeForce RTX 5090能够以惊人的速度将数据传输到其CUDA核心。 由于 GPU 无需等待数据,模型训练速度更快。32GB GDDR7 显存还支持对超过 24GB 的模型进行推理。您可以运行更大的批次,从而获得更高的吞吐量。科学计算也能从这种内存带宽中受益。流体动力学或分子建模等模拟需要快速的数据访问。RTX 5090 能够始终如一地提供这种访问速度。硬件断电保护功能增强了企业级可靠性。即使发生意外断电,长时间的训练运行也不会出现数据损坏。这一特性使 RTX 5090 区别于消费级 GPU 产品。 软件生态系统和人工智能基准NVIDIA 将 CUDA 生态系统维护为人工智能开发的行业标准。您可以访问针对深度学习、计算机视觉和科学计算优化的库。PyTorch 和 TensorFlow 等热门框架可在此平台上原生运行。GPU 可加速模型训练、推理和微调任务。实际基准测试证实了其性能优势。在 ResNet-50 训练中,RTX 5090 在 FP32 精度下每秒可处理 1128.6 个样本,而 RTX 4090 为每秒 757.5 个样本。在 FP16 精度下,RTX 5090 达到每秒 1623.9 个样本,而上一代旗舰产品为每秒 1360.6 个样本。这些结果表明,在各种精度模式下,RTX 5090 的性能均有显著提升。您的深度学习流程可以更快完成。此外,GPU 在推理工作负载方面也表现出色。您可以以更低的延迟部署训练好的模型。科学计算应用也能从相同的架构中受益。 研究人员运行的模拟程序以前需要多个 GPU 单元才能完成。CUDA 生态系统提供成熟的工具来支持这些工作负载。您可以轻松获取文档、社区支持和企业级支持。DLSS 技术还利用 Tensor Core 来提升游戏性能。这种双用途设计使 RTX 5090 在 AI 研究和娱乐领域都极具价值。该 GPU 可高效处理专业的 3D 渲染和 CGI​​ 制作。视频编辑人员可以实现 8K 实时播放。虚拟制作工作室依靠这种性能来实现数字孪生。该 GPU 符合企业级可靠性标准。硬件断电保护功能可确保您的工作在断电后仍能继续运行。RTX 5090 是追求极致性能的 AI 专业人士的理想之选。这款GPU与竞争对手相比如何 与上一代旗舰相比将 RTX 5090 与 RTX 4090 并排比较,就能看出最大的性能提升。新款显卡拥有 21,760 个 CUDA 核心,而 RTX 4090 则只有 16,384 个;此外,新款显卡还配备了 32GB 的 GDDR7 显存,是老款 24GB 显存的两倍。显存带宽从 1,008 GB/s 提升至 1,792 GB/s,增幅高达 78%。如此高的显存带宽能够流畅运行大型语言模型和 8K 纹理,而不会出现卡顿。在 ResNet-50 训练中,RTX 5090 在 FP32 采样率下达到了每秒 1,128.6 个样本,而 RTX 4090 则为每秒 757.5 个样本。这意味着训练运行速度更快,推理延迟也更低。 功耗方面也存在类似情况。RTX 5090 的规格参数显示其额定功耗为 575W,而 RTX 4090 为 450W。在游戏负载下,新款显卡的功耗为 685W,而旧款为 610W。峰值瞬时功耗更是高达 1150W,而旧款仅为 850W。因此,你需要一个 950W 的电源,而不是老款旗舰显卡推荐的 850W 电源。RTX 5090 的额定功率为 575 瓦,而 RTX 4090 的额定功率为 450 瓦,这意味着其性能提升的同时,功耗也显著增加。 与当前一代竞争对手相比AMD 的 RX 7900 XTX 在满载时功耗为 355W,需要搭配 800W 的电源。RTX 5090 的功耗更高,但在游戏和 AI 任务中性能却远胜于 RX 7900 XTX。其 CUDA 生态系统赋予了它无可匹敌的软件优势。在 3D 渲染和 CGI​​ 制作等专业工作负载下,这款 GPU 的运行速度更快。RTX 5090 的价格也反映了这种差距。你需要预先支付更高的价格,而且散热和供电的成本也更高。一个坚固的机箱和一个优质的 950W 电源都会增加总成本。尽管如此,目前还没有其他显卡能够达到它相同的基准测试成绩。RTX 5090 凭借其卓越的性能,稳坐顶级显卡的宝座,满足了追求极致性能用户的需求。  RTX 5090 堪称游戏和 AI 领域最佳 GPU,其卓越性能在各项基准测试中均有体现。NVIDIA GeForce RTX 5090 在 4K 和 8K 分辨率下可提供无与伦比的帧速率。其 32GB GDDR7 显存可加速模型训练。这款 GPU 非常适合 4K 和 8K 游戏玩家、AI 研究人员、内容创作者和工作站用户。如果您只玩 1080p 游戏,则可以考虑其他选择。其价格和成本体现了旗舰级产品的地位。此外,您还需要一个 950W 的电源。NVIDIA 的这款 GPU 为未来几代显卡树立了标杆,目前没有任何其他 GPU 能与之匹敌。未来最优秀的显卡都将效仿这款 GPU 的发展方向。但需要注意的是,它的入门成本较高。 常问问题RTX 5090 需要什么样的电源?你需要一个 950W 的电源。这张显卡在满载时功耗为 575W,瞬态峰值功耗会更高。一个高质量、供电稳定的电源可以防止系统不稳定。RTX 5090 比之前的旗舰显卡需要更大的电源余量。32GB 显存如何帮助 AI 工作负载?您无需交换到系统内存即可运行更大的模型。32GB 的显存足以处理大型语言模型和高分辨率数据集。由于 GPU 可以快速访问数据,因此训练速度更快。此容量支持对超过 24GB 的模型进行推理。DLSS 4.5 能提升游戏性能吗?是的。DLSS 4.5 的多帧生成功能会在渲染帧之间插入额外的帧,从而显著提升高配置游戏的帧率。您可以在设置中启用此功能,获得流畅的 4K 路径追踪效果。这项技术适用于众多游戏。是否应该从 RTX 4090 升级?您将获得 78% 的内存带宽提升和约 33% 的 CUDA 核心数量增加。NVIDIA GPU 能够更快地训练模型并流畅渲染 8K 内容。但入门成本较高,并且需要更换电源。如果您追求极致性能,建议升级。这款GPU是否支持专业工作负载?是的。NVIDIA GPU 可处理 3D 渲染、CGI 制作和实时 8K 视频编辑。硬件断电保护功能增强了企业级可靠性。CUDA 生态系统支持深度学习和科学计算。这款 GPU 完全满足工作站的需求。
  • 什么是固态硬盘 (SSD)?它在 2026 年的工作原理是什么?
    什么是固态硬盘 (SSD)?它在 2026 年的工作原理是什么?
    September 03, 2026
    你按下电源按钮。你的旧电脑需要一分钟才能启动到桌面。而你的新电脑只需几秒钟就能启动。你有没有想过这是为什么?答案就在于存储方式。你的新电脑使用的是固态硬盘 (SSD)。这种存储方式依靠的是存储芯片,而不是机械部件。之前的硬盘驱动器与固态硬盘的对比就突出了这种变化。机械硬盘 (HDD) 使用旋转的盘片。而固态硬盘则将数据存储在闪存中,因此速度更快、更可靠。这种速度差异非常显著。下表显示了典型的启动时间。系统硬盘启动时间(秒)SSD启动时间(秒)Windows 1160–9012-17Linux Ubuntu45–708-15性能提升源于固态设计。没有移动部件意味着更低的延迟,您可以即时访问文件。要点总结固态硬盘使用闪存,没有移动部件,因此比机械硬盘速度更快、更可靠。选择 NVMe SSD 可获得最高速度,尤其适用于游戏或繁重任务。固态硬盘 (SSD) 静音、耐用且功耗低,是笔记本电脑的理想选择。升级到固态硬盘,可加快启动速度并提高整体性能。在选择固态硬盘 (SSD) 时,请考虑您的需求和预算,因为固态硬盘每 GB 的价格比机械硬盘 (HDD) 更高。固态硬盘如何存储数据NAND闪存:数字存储单元固态硬盘使用非易失性闪存。这意味着即使电脑关机,数据也能完好无损。想象一下,一个巨大的网格由无数个小方格组成。每个方格,称为NAND闪存单元,都储存着电荷。这些电荷以二进制代码(0和1)的形式代表你的数据。电荷的存在与否决定了存储的值。并非所有存储单元都存储相同数量的数据。制造商根据每个存储单元存储的位数对NAND闪存进行分类。下表列出了2026年您将遇到的常见类型。细胞类型每个单元格的比特数盐湖城1MLC2薄层色谱法3QLC4每个存储单元存储的比特数越多,成本越低,容量越大。然而,这种高密度是以牺牲耐用性为代价的。每个存储单元在达到使用寿命之前,只能承受有限次数的编程/擦除循环。下表列出了典型的耐用性范围。NAND 类型每个单元格的比特数典型耐久性(编程/擦除周期)盐湖城15万至10万MLC23,000 – 10,000薄层色谱法31,000 – 3,000QLC4150 – 1,000现代固态硬盘通过3D NAND架构克服了耐用性限制。制造商不再将存储单元平铺在单个平面上,而是将它们垂直堆叠成层。这种方法在不缩小单个存储单元尺寸的情况下,显著提高了容量。如今,一块2.5英寸的固态硬盘可以存储超过1TB的数据。与传统的平面设计相比,这种垂直设计还能减少电子干扰,从而提高可靠性。控制器:固态硬盘的大脑NAND闪存单元存储您的数据,但控制器负责管理一切。这个小型处理器充当所有固态硬盘存储操作的流量指挥中心。它与计算机的内存(RAM)通信,并将请求转换为闪存上的物理操作。控制器执行多项关键任务以维持固态硬盘的性能:Flash转换层(FTL): 将操作系统中的逻辑块地址转换为物理 NAND 位置。磨损均衡化: 将写入/擦除周期均匀分配到所有块上,以防止任何单个区域过早磨损。垃圾收集: 在空闲时间,合并部分填充块中的有效数据,并擦除旧块以回收空间。纠错码(ECC): 检测并纠正闪存随着时间推移而劣化时发生的位错误。TRIM 命令: 告知驱动器哪些数据块不再需要,从而实现高效的垃圾回收。控制器还负责管理主机系统和NAND闪存之间的数据传输。保存文件时,控制器会收到包含逻辑块地址的命令。然后,它会将该地址转换为物理页位置。由于NAND闪存无法就地覆盖数据,控制器会为更新后的数据分配一个新的位置,并更新其映射表。此过程在几毫秒内完成。固态硬盘没有移动部件,因此消除了机械延迟。您的系统几乎可以瞬间访问数据。这种设计也避免了因设备跌落或碰撞而导致的机械故障风险。现代控制器甚至可以智能地调度后台任务,确保垃圾回收不会干扰您正在进行的工作。无论您是使用消费级硬盘进行游戏还是其他用途,固态硬盘都能满足您的需求。 企业级 NVMe SSD 比如 Solidigm D7-P5520 对于数据中心而言,控制器可确保性能稳定。即使是运行在数据中心等高要求应用上的应用,也能保持性能稳定。 NVIDIA GeForce RTX 5090 受益于基于闪存的快速存储访问。SATA固态硬盘:通用升级方案SATA 固态硬盘是目前最容易入门的固态存储设备。这些硬盘采用与传统机械硬盘相同的接口,因此几乎兼容过去十年生产的所有台式机和笔记本电脑。无需特殊适配器或修改 BIOS,即可将其安装到现有系统中。2.5 英寸的固态硬盘外形纤薄,呈长方形,尺寸约为 100 毫米 x 70 毫米,厚度仅为 7 毫米。这种尺寸的硬盘可以安装在大多数台式机机箱的标准硬盘位中。SATA III 的理论性能上限为 600 MB/s,但实际速度读取速度约为 550 MB/s,写入速度约为 520 MB/s。这些数据相比机械硬盘有了显著提升。然而,SATA 接口本身存在瓶颈。该协议最初是为机械硬盘而非闪存设计的。正是由于这一限制,SATA SSD 存储解决方案与更新的替代方案相比,性能提升虽然稳定但并不显著。NVMe SSD:利用 PCIe 实现最高速度NVMe(非易失性内存高速接口)彻底消除了SATA的瓶颈。NVMe无需通过SATA控制器路由数据,而是直接通过PCIe总线与系统CPU通信。这种架构差异将命令延迟从AHCI的约6微秒降低到NVMe的仅2.8微秒。该协议专为闪存而设计,支持并行数据路径,从而最大限度地提高吞吐量。物理设计也截然不同。M.2 NVMe 固态硬盘外形像一根根小棒,而非方盒子,宽度仅为 22 毫米,长度通常为 80 毫米,厚度仅为 2 毫米。这种紧凑型设计重量仅为 5 到 10 克,而 2.5 英寸 SATA 固态硬盘的重量则为 40 到 60 克。笔记本电脑从这种空间利用率中获益匪浅,制造商得以在不牺牲固态硬盘存储容量的前提下,打造更轻薄的设备。性能数据清晰地展现了不同接口之间的差距。基于 PCIe 4.0 的 NVMe 固态硬盘理论速度可达 8000 MB/s,实际读取速度在 7000 至 7400 MB/s 之间。这相当于 SATA III 速度的大约十倍。最新的 PCIe 5.0 接口将理论速度上限提升至约 16000 MB/s,足以满足 AI 分析和高性能计算等高负载应用的需求。使用 NVIDIA GeForce RTX 5090 显卡的游戏玩家会发现,NVMe 固态硬盘能够带来更快的关卡加载速度和纹理流传输速度。数据中心部署的企业级 NVMe SSD 解决方案(例如 Solidigm D7-P5520)也依赖于这种速度来运行关键任务型应用。固态硬盘类型的选择取决于主板的可用插槽数量和性能需求。SATA 硬盘兼容性强,价格也更低。NVMe 硬盘则能为追求极致响应速度的用户提供无与伦比的速度。固态硬盘 (SSD) 与机械硬盘:哪个更好?将固态硬盘 (SSD) 与传统硬盘进行比较,差异显而易见。其核心区别在于机械设计。传统硬盘依靠旋转的盘片和移动的读写磁头进行读写操作,而固态硬盘则使用闪存芯片,没有任何移动部件。这一根本差异决定了其他所有比较点。速度、耐用性和噪音:主要区别速度 固态硬盘最显著的优势在于其速度。由于没有旋转的磁盘,系统几乎可以瞬间访问数据。启动时间从一分钟以上缩短到几秒钟。应用程序也能立即启动。这种速度提升彻底改变了您的日常计算体验。固态硬盘与机械硬盘的对比表明,固态硬盘消除了传统硬盘固有的机械延迟。耐久性 此外,固态硬盘 (SSD) 的设计也更受青睐。由于没有移动部件,SSD 比 HDD 更能抵抗物理冲击。硬盘驱动器可靠性数据显示,SSD 的故障率更低。Backblaze 在 2024 年第二季度评估了 284,386 个硬盘驱动器,发现硬盘驱动器的年平均故障率为 1.71%。Schroeder & Gibson 的一项研究报告称,HDD 的总体加权年更换率为 3.01%。故障率范围从 0.5% 到 13.5% 不等,具体取决于硬盘的使用年限。制造商的数据表列出的固态硬盘的典型年故障率 (AFR) 为 0.58% 到 0.88%。闪存驱动器的更换率远低于传统硬盘驱动器,但它们的不可纠正错误率可能更高。从长远来看,SSD 存储解决方案能为您的数据提供更高的可靠性。噪音 这是固态硬盘的另一大优势。固态硬盘在任何运行条件下都不会产生噪音。而机械硬盘则会产生来自旋转盘片和磁头的噪音。存储类型噪音水平(分贝)运行条件硬盘(企业级,600GB SAS)30–35正常运行硬盘(企业级,600GB SAS)40–45重载固态硬盘(SATA/SAS 型号)0(静默)所有条件这种安静的环境有助于营造更舒适的电脑使用环境。转换的利弊固态硬盘的优势显而易见。它能带来更快的启动速度、更安静的运行、更强的耐用性和更低的功耗。由于没有移动部件,发热量更低,这对笔记本电脑尤为有利。能效也是其一大优势。固态硬盘比机械硬盘功耗更低,从而延长了笔记本电脑的电池续航时间。这些优势的综合作用使固态硬盘成为现代电脑的首选。对于像使用高端显卡(例如 NVIDIA GeForce RTX 5090)运行游戏这样对性能要求极高的应用,固态硬盘可以确保纹理快速加载。企业用户则可以受益于像 Solidigm D7-P5520 这样的企业级 NVMe 固态硬盘解决方案,这些方案能够为数据密集型工作负载提供稳定的性能。主要缺点仍然是成本。硬盘驱动器和固态硬盘的成本比较显示,固态硬盘每GB的价格仍然高于机械硬盘。下表显示了当前的价格。容量SSD NVMe 成本2.5英寸固态硬盘成本硬盘成本1 TB38.99美元34.99美元26.99美元2TB69.98美元68.98美元35.99美元4TB199.99美元179.99美元49.64美元8TB899.99美元499.00美元99.99美元16 TB-2499.99 美元224.99美元固态硬盘 (SSD) 和机械硬盘 (HDD) 之间的价格差距近年来有所缩小,但仍然存在。4TB 的 SSD 价格大约是 HDD 的四倍。另一个需要考虑的因素是使用寿命。大多数现代 SSD 在正常日常使用情况下可以使用 5 到 10 年,通常超过保修期。对于重度用户来说,写入寿命也是一个需要考虑的因素。现代 SSD 通过损耗均衡技术来解决这个问题,确保硬盘可以使用多年。对于您的主要存储设备而言,这种长寿命使得投资 SSD 物有所值。对大多数用户而言,固态硬盘的优势远大于其较高的价格。单是性能提升就足以证明这笔投资的合理性。硬盘和固态硬盘的选择最终取决于您的预算和存储需求。如果您既需要速度又需要容量,可以将固态硬盘与传统硬盘搭配使用,以实现大容量存储。固态硬盘的多功能性使其既适用于日常计算,也适用于专业工作负载。实用指南:升级到固态硬盘如何选择适合您需求的固态硬盘你的主要使用场景决定了哪款固态硬盘最适合你的工作流程。例如,游戏玩家如果将系统与 NVIDIA GeForce RTX 5090 等高端显卡搭配使用,就需要一块随机读取速度快的 NVMe 固态硬盘。内容创作者的需求则有所不同。在高级设置中,你需要为系统、进行中的项目和缓存文件分别配备独立的硬盘。单硬盘配置会迫使你做出妥协,从而拖慢你的编辑进度。因素关键考虑因素实用指南驱动类型系统驱动器优先考虑低延迟;项目驱动器需要持续高速和DRAM。在高端配置中,系统盘、项目盘和缓存盘应使用独立的固态硬盘。容量和总带宽更高的容量意味着更低的每TB成本和更高的总TBW额定值。为了获得最佳性价比,建议选择至少 1TB 至 2TB 的硬盘;容量更大的硬盘在高强度写入操作下使用寿命更长。DRAM缓存配备DRAM的硬盘可以防止长时间写入过程中出现速度下降。项目驱动器最好使用DRAM;缓存驱动器可以使用非DRAM选项。实际速度标称的顺序读写速度很少能持续;随机读写速度更为重要。查看 PCMark 10 等基准测试结果;预计实际传输速度在 2,500–3,000 MB/s 左右。独立剪辑师处理小型项目至少需要 1TB 的 SSD 存储解决方案。小型团队高效协作,可受益于 4TB 至 8TB 容量的集中式 NAS。大型团队制作高清视频时,需要 20TB 或以上的共享存储。专业工作室制作 4K/8K 内容,为了获得最佳性能和满足未来的扩展需求,应投资超过 50TB 的 SAN 存储方案。项目分辨率、并发用户数和备份需求都是影响最终决策的因素。企业级工作负载需要不同的考量。像 Solidigm D7-P5520 这样的企业级 NVMe SSD 可为运行 AI 分析或数据库应用的数据中心提供稳定的 SSD 存储性能。这些硬盘具有更高的耐用性和断电保护功能,而消费级产品则不具备这些特性。安装与使用寿命:健康驾驶小贴士从硬盘驱动器升级到固态硬盘时,您有两种安装方式。克隆会将您的整个操作系统和文件复制到新的固态硬盘上。全新安装则能让您拥有一个干净的系统,清除所有累积的数字垃圾。大多数用户出于方便起见会选择克隆,但全新安装通常能带来更好的固态硬盘长期性能。TRIM 指令在维护硬盘健康方面起着至关重要的作用。这条操作系统指令会告知固态硬盘 (SSD) 在文件删除后哪些数据块不再需要。然后,硬盘会主动擦除并准备好这些数据块,以便将来写入数据。此过程可减少写入放大和不必要的擦除周期。通过最大限度地减少内部数据移动,TRIM 指令可以降低闪存单元的损耗,从而延长硬盘的使用寿命。您还应该定期使用制造商提供的工具更新硬盘固件。在操作系统设置中启用 TRIM 功能,以确保自动维护。请勿撕下硬盘上的标签,否则可能会使您的保修失效。定期运行基准测试,以验证您的固态硬盘是否保持预期的速度水平。这些简单的操作可以确保您的固态硬盘多年保持响应迅速。安装后,您将体验到启动速度和应用程序加载速度的显著提升,这将彻底改变您的日常计算体验。固态设计彻底改变了您的计算体验。没有移动部件意味着更快的启动速度、更安静的运行和更长的使用寿命。无论您是使用 NVIDIA GeForce RTX 5090 玩游戏,还是使用 Solidigm D7-P5520 企业级 NVMe SSD 管理企业工作负载,您的 SSD 都能即时传输数据。到2026年,固态存储将成为标配而非可选配置。市场也反映了这一转变。企业级固态硬盘(SSD)收入将从2024年的85亿美元稳步增长至2033年的215亿美元,复合年增长率达12.3%。如今,这一计算机存储类别已在新系统构建中占据主导地位。存储技术不断发展。更快的接口和更高密度的内存每年都在涌现。如果您还在使用机械硬盘,现在就升级吧。未来的您会感受到其中的差别。常问问题固态硬盘的实际使用寿命有多长?现代固态硬盘在正常日常使用情况下可使用 5 到 10 年。损耗均衡技术可将写入周期均匀分配到所有存储单元。这项技术可防止任何单个区域过早磨损。大多数硬盘的使用寿命都超过了保修期,且不会出现任何问题。我可以在我的旧电脑里安装固态硬盘吗?是的,您可以升级过去十年几乎所有台式机或笔记本电脑。SATA 固态硬盘使用与传统硬盘相同的接口。您的系统无需特殊适配器或更改 BIOS 设置即可识别该硬盘。这种兼容性使得固态硬盘成为最简单的性能升级方案。SSD 能提升我的游戏体验吗??没错。游戏加载速度更快,纹理传输也更加流畅,不会出现卡顿。将固态硬盘与NVIDIA GeForce RTX 5090等高性能显卡搭配使用,可以彻底消除存储瓶颈。你会发现加载时间更短,开放世界探索也更加流畅。企业级 NVMe SSD 固态硬盘与消费级产品有何不同?企业级固态硬盘,例如 Solidigm D7-P5520,具有更高的耐用性和断电保护功能,即使在持续高负载下也能保持稳定的性能。消费级固态硬盘则优先考虑日常任务的成本效益。数据中心需要企业级 NVMe SSD 解决方案所提供的可靠性。
  • NVIDIA SN5600 或 Cisco 800GbE:现代数据中心的全面对比
    NVIDIA SN5600 或 Cisco 800GbE:现代数据中心的全面对比
    August 27, 2026
    在以下两者之间进行选择 NVIDIA Spectrum-4 SN5600 思科 Nexus G200 将助力您构建完整的 AI 网络战略。您需要一款能够处理海量 GPU 流量且无瓶颈的交换机。NVIDIA 平台与 Spectrum-X 和 BlueField-3 深度集成,构建了一个紧密耦合的架构,可加速计算。思科则凭借其多厂商兼容性和 UEC 合规性,满足异构环境的需求。 数据中心的未来取决于此决策。NVIDIA 的网络架构在无损以太网和自适应路由方面表现卓越,可最大限度地降低分布式训练的尾延迟。思科的优势在于基于标准的互操作性,允许您混合使用来自多个供应商的设备。您必须权衡生态系统锁定和运营自由之间的利弊。考虑您的 AI 工作负载规模以及您对供应商特定优化的容忍度。此比较有助于您根据自身具体需求评估这两个平台。 要点总结选择 NVIDIA SN5600,可与 DGX 和 BlueField-3 紧密集成,实现 AI 生态系统的卓越性能和自动化。选择 Cisco Nexus G200,可实现多厂商灵活性和 UEC 合规性,是异构和受监管环境的理想之选。两款交换机均可提供 51.2 Tbps 的吞吐量,但 NVIDIA 在无损以太网和自适应路由方面表现出色,而 Cisco 则提供精细的流量工程。评估您的工作负载规模、生态系统投入和合规性需求,以使您的选择与长期基础设施目标保持一致。在正式投入之前,先使用实际工作负载进行概念验证,以验证性能和操作兼容性。 平台概述:SN5600 与 Cisco Nexus G200 对比在评估性能指标之前,您需要了解每个平台的驱动因素。NVIDIA Spectrum-4 SN5600 和 Cisco Nexus G200 代表了 800GbE 网络的两种截然不同的设计理念。您在它们之间做出的选择将决定您的整个 AI 架构战略。NVIDIA Spectrum-4 SN5600 内部结构:ASIC 和缓冲器NVIDIA Spectrum-4 SN5600 的核心是一颗专为 AI 工作负载设计的 ASIC 芯片,可提供卓越的吞吐量。这款交换机提供 51.2 Tbps 的双向带宽,确保高吞吐量和低延迟。其卓越的性能得益于巧妙的 SerDes 设计:Spectrum-4 ASIC 使用 100 Gb/s SerDes 通道,通过 50 Gb/s 本地信号和 PAM-4 编码(每个信号 2 位)实现。这些通道以 8 个为一组组成一个 800 GbE 端口。共有 64 个这样的端口,总吞吐量计算如下:64 个端口 × 800 Gb/s = 51.2 Tb/s。此配置专门针对区域数据中心互连,其中 800 GbE 端口是关键实现因素。除了高速传输之外,SN5600 还采用了完全共享的动态数据包缓冲架构。这种设计能够有效吸收微突发流量,从而在分布式训练过程中保持可预测的低延迟。此外,它还原生支持 RoCE,并针对 NVIDIA Spectrum-X 以太网进行了优化,为 GPU 集群构建了紧密集成的网络架构。该交换机每秒可处理高达 333 亿个数据包,确保在持续负载下不会出现丢包。 Cisco Nexus G200:Silicon One 和 UEC 就绪性思科 Nexus G200 采用不同的设计方案,搭载 Silicon One G200 ASIC 芯片。这款交换机强调多厂商互操作性和标准兼容性。灵活的端口配置可适应各种网络环境,让您从中受益。规格价值吞吐量51.2 Tbps(全双工)端口配置从 64x800GE 到 512x100GE思科将此平台定位为面向统一工程中心 (UEC) 的就绪平台,这意味着您可以将其集成到异构架构中,而无需担心专有技术锁定。Silicon One 架构支持高级流量工程,使您能够对数据流进行精细控制。对于合规性要求高的环境,思科 Nexus 系列提供熟悉的 NX-OS 管理界面,从而降低运维开销。 您的选择取决于您对生态系统的优先级。如果您致力于集成 NVIDIA Spectrum-X 以太网和 BlueField-3,NVIDIA 平台将发挥其优势。如果您需要跨多个供应商的灵活性,Cisco 则更具吸引力。两款交换机均提供 51.2 Tbps 的吞吐量,但它们的优势在于如何处理 AI 架构优化和基于标准的适应性。 并排规格对比你需要具体的数值来评估这些平台。两款交换机都能提供 51.2 Tbps 的全双工吞吐量,但它们的架构选择却截然不同。下表列出了你必须考虑的关键规格。规格NVIDIA Spectrum-4 SN5600思科 Nexus G200专用集成电路光谱-4Silicon One G200吞吐量51.2 Tbps51.2 Tbps端口密度64x800GbE 到 512x100GbE从 64x800GE 到 512x100GE数据包处理33.3 Bpps同等线路速率缓冲架构完全共享的动态数据包缓冲区可配置共享缓冲区管理操作系统Cumulus Linux / NVIDIA 操作系统NX-OS 性能统计:线路速率、端口和延迟NVIDIA Spectrum-4 SN5600 可同时在所有 64 个端口上实现真正的 800G 线速。这一性能得益于采用 PAM-4 编码的 100 Gb/s SerDes 通道。每个端口将八条通道组合成一个 800GbE 连接。这种配置旨在为区域数据中心互连提供高密度 800GbE 端口,从而消除瓶颈。 思科 Silicon One G200 交换机在端口密度方面与此交换机不相上下。您可以灵活配置交换机,从 64 个 800GE 端口到 512 个 100GE 端口不等。这种灵活性适用于各种网络拓扑结构。两个平台都能以线速处理数据包,即使在持续负载下也不会丢帧。 延迟在这些交换机之间产生了细微的差别。NVIDIA 平台通过其动态缓冲区设计实现了可预测的低延迟。即使在微突发事件期间,您也能体验到稳定的数据包转发。思科通过其 Silicon One 架构实现了类似的延迟,但其缓冲区管理策略有所不同。您的工作负载将决定哪种方法更适合您。 拥塞控制和自适应路由AI 工作负载会产生独特的流量模式,使传统的拥塞控制机制不堪重负。您需要智能化的网络架构管理来维持分布式训练期间的吞吐量。两家供应商针对这一挑战采取了不同的应对方式。NVIDIA 在 Spectrum-4 ASIC 芯片中直接实现了自适应路由。该功能无需 CPU 干预即可动态地绕过拥塞路径重新路由流量。您可以受益于根据实时网络状况自动选择的路径。该交换机将此功能与原生 RoCEv2 支持相结合,从而为 RDMA 流量实现无损以太网传输。NVIDIA 的方法通过在热点形成之前就加以预防,最大限度地减少了尾延迟。 思科主要依赖基于标准的拥塞控制机制,特别是数据中心量化拥塞通知 (DCQCN)。您可以配置明确的拥塞通知阈值来管理缓冲区占用率。Silicon One ASIC 支持高级流量工程,使您能够对流放置进行精细控制。这种基于标准的方法确保了与您网络架构中的第三方交换机的互操作性。 不同平台的管理体验差异显著。NVIDIA 提供 Cumulus Linux,为您提供熟悉的基于 Linux 的操作系统环境。您可以使用标准的 DevOps 工具实现交换机的自动化。Cisco 的 NX-OS 提供网络工程师已经熟悉的命令行界面。您团队的操作经验应影响您的选择。 对于 AI 架构优化而言,NVIDIA 的自适应路由具有显著优势。交换机能够自动平衡可用路径上的流量,从而减少因拥塞导致的丢包。思科的方法需要更多手动调整,但能为特定环境提供更强大的控制能力。您必须评估自动化或精细化控制哪种方式更符合您的运营模式。 缓冲区架构是另一个关键区别。NVIDIA 的全共享动态缓冲区能够有效吸收微突发流量,从而在突发性 AI 流量期间保持性能稳定。Cisco 的可配置缓冲区则允许您根据特定的流量特征分配资源。两种方法都能防止丢包,但它们实现这一目标的机制不同。 最终的选择取决于网络架构的复杂性和团队的专业水平。NVIDIA 平台在高度集成的 AI 环境中表现出色,尤其适用于自动化至关重要的环境。而 Cisco 的灵活性则更适合需要手动优化的异构网络。 性能和 AI Fabric 特性 无损以太网和 RDMA 优化您的 AI 集群需要无损以太网来保护 RDMA 流量免受丢包影响。NVIDIA SN5600 提供原生 RoCEv2 支持,并配备完全共享的动态数据包缓冲区。这种架构可在交换机级别吸收微突发流量,防止拥塞蔓延至整个网络结构。即使在以下情况下,您也能保持可预测的延迟: 多GPU 训练检查点期间,节点同时爆发。 思科通过数据中心桥接协议实现无损传输。优先级流控制 (PFC) 发送暂停帧来管理以太网流,而显式拥塞通知 (ECN) 则标记发生拥塞的数据包,而不会丢弃它们。这种基于标准的方法可以与网络中的第三方交换机互操作。您可以通过 NX-OS 配置这些机制,并调整阈值以匹配您的工作负载特性。 NVIDIA 平台通过动态缓冲区分配最大限度地降低了尾延迟。当某个端口出现突发流量时,交换机会自动从空闲端口重新分配缓冲区容量。这样,分布式训练作业就能避免因延迟而导致的整体迭代时间变慢。Cisco 的可配置缓冲区需要手动调整,但可以针对特定流量模式提供精细的控制。 面向人工智能工作负载的流量工程NVIDIA Spectrum-X 以太网将自适应路由直接集成到 ASIC 中。交换机无需 CPU 干预即可绕过拥塞路径重新路由流量,并能响应实时网络状况。您可以受益于自动路径选择功能,该功能可防止热点在形成之前出现。对于 AI 后端网络而言,此功能至关重要,因为流量模式会在数千个 GPU 连接之间不可预测地变化。 思科的智能数据包流 (IPF) 技术是一套全面的流量工程套件。Silicon One G200 支持动态负载均衡(基于流),可根据链路利用率遥测数据分配流量。此外,它还支持逐包负载均衡,可将数据包分散到多条路径上以实现最大吞吐量。加权成本多路径 (WCMP) 技术可针对非对称拓扑结构实现智能路径加权。基于策略的负载均衡可根据访问控制列表 (ACL)、DHCP 标记或 RoCEv2 报头为混合工作负载分配特定的策略。 这些平台在人工智能工作负载分析方面,可视性是其区别所在。思科提供硬件流遥测功能,可统计交换机上传输的每个数据包,包括微突发和丢包。ECN 标记计数器通过 Nexus Dashboard Insights 报告每个设备、每个接口以及流级别的拥塞情况。PFC 数据包统计信息揭示了每个服务等级发出的暂停帧,从而实现实时拥塞调优。NVIDIA 计数器与 Spectrum-4 的集成遥测功能配合使用,通过 Spectrum-X 管理平台提供全网络可视性。 您的AI后端架构可同时受益于这两种方法。NVIDIA的自适应路由减少了人工干预,非常适合自动化程度高的大规模AI训练。Cisco基于策略的控制则适用于需要精确流量处理的异构环境。您选择的交换机决定了您对AI集群数据流的控制程度。 使用场景:何时选择哪种场景您的工作负载特性决定了哪个平台最适合您。NVIDIA SN5600 在高度集成的 AI 环境中表现出色,而 Cisco Nexus G200 则在异构、合规性驱动的网络中大放异彩。了解这些场景有助于您将基础设施投资与实际运营情况相匹配。 NVIDIA SN5600 适用于紧凑型 NVIDIA 生态系统(DGX、BlueField)当您的计算节点、存储和网络构成统一的堆栈时,您便构建了一个以 NVIDIA 为中心的 AI 基础架构。NVIDIA Spectrum-4 sn5600 可与 DGX SuperPOD 架构无缝集成,提供 GPU 集群所需的带宽。NVIDIA 专为 Spectrum-X 以太网架构设计了这款交换机,打造了一个所有组件都能高效通信的统一环境。 DGX SuperPOD 参考架构清晰地展示了这种集成。您可以将 AI 训练环境从 2,304 个 GPU 扩展到 16 个可扩展单元 (SU) 上的 9,216 个 GPU。每个 SU 将两台 SN5600 交换机配对作为脊梁层,聚合面向 DGX 计算托架和存储的叶交换机。对于更大规模的部署,您可以添加一个包含两个组的超级脊梁层,从而在整个架构中保持无阻塞特性。规模(GPU)量表(SUs)超级脊柱组每组超级脊柱超级脊柱开关总和全脊柱开关2304422464460882481289216162714256921616624144512 BlueField-3 DPU 集成可进一步提升您的 AI 集群性能。DOCA 2.7 版本支持 Spectrum-X 1.0.1 参考架构,该架构专为搭配 SN5600 交换机的 BlueField SuperNIC 而设计。此架构通过自适应路由和 DOCA 可编程拥塞控制实现无损以太网连接。BlueField SuperNIC 默认以网卡模式交付,可实现 GPUDirect RDMA,从而简化部署。 基准测试结果充分证明了其显著优势。使用 SN5600 和 BlueField-3 的 GPUDirect RDMA,完成一项微调工作负载仅需 1 小时 40 分钟。同样的工作负载,使用 Spectrum-4 以太网上的 TCP/Socket 连接则需要 2 小时 30 分钟,而使用默认的 OVN 网络则需要 5 小时。相比基准配置,性能提升了 3 倍,直接加速了 AI 训练周期。 适用于多厂商和 FedRAMP 环境的 Cisco Nexus G200当您的数据中心涉及多个供应商,且合规性要求是您决策的首要考量时,思科 Nexus G200 是您的理想之选。这款交换机支持 UEC 标准,让您可以集成来自不同制造商的设备,而无需担心专有技术的限制。随着标准的演进,您的网络将始终保持开放性和适应性。 Cisco Nexus 平台在无法完全依赖单一生态系统的环境中表现出色。您可以混合使用不同厂商的交换机,从而在整个基础架构中保持运维灵活性。NX-OS 管理为您的网络工程团队提供熟悉的工具,降低了培训成本和运维风险。 FedRAMP 合规性对于政府和受监管行业而言是一项关键的差异化优势。思科成熟的合规框架简化了您的认证流程。您可以将 G200 部署到需要严格安全控制的环境中,因为该平台符合严苛的联邦标准。这项功能对于公共部门合同和受监管的商业工作负载至关重要。 思科基于策略的流量工程技术可显著提升您的 AI 后端架构。无论您是运行大规模分布式训练还是推理,都可以配置与特定工作负载模式相匹配的负载均衡策略。Silicon One G200 ASIC 芯片可对数据流进行精细控制,从而实现对 AI 集群资源的精准管理。 最终的决定取决于您的生态系统战略。选择 英伟达 当您致力于构建与 DGX 和 BlueField 组件紧密集成的 AI 技术栈时,思科是您的理想之选。如果您需要多厂商灵活性、UEC 合规性和成熟的监管资质,思科也是您的最佳选择。您的 AI 后端架构应体现贵组织的长期基础设施愿景。 决策框架和清单关键选择标准:规模、生态系统和标准评估首先要考虑工作负载规模。NVIDIA SN5600 在运行拥有数千个 GPU 的大规模 AI 训练环境时表现出色。Cisco Nexus G200 则适用于异构架构,在这些架构中,多厂商互操作性比紧密集成更为重要。在选择任何平台之前,您必须诚实地评估您的 AI 集群的增长轨迹。 生态系统承诺对您的决策影响巨大。NVIDIA 平台与 DGX 系统和 BlueField-3 DPU 搭配使用时,可发挥最大价值。这种集成可构建一个具有自动化优化功能的统一 AI 架构。Cisco Nexus 方案则提供了运维自由,允许您混合使用不同厂商的交换机,而无需受专有技术的限制。您对厂商锁定的容忍度决定了哪种方案更符合您的基础设施战略。 标准准备情况影响着长期的可行性。思科将 G200 定位为符合 UEC 标准,确保网络能够随着行业标准的演进而面向未来。NVIDIA 则专注于 Spectrum-X 优化,通过其专有增强功能,在当下即可提供卓越的性能。您必须权衡 AI 工作负载分析带来的即时收益与未来的互操作性需求。 数据中心架构师实用检查清单在选择 800GbE 交换机平台之前,请先完成以下清单:记录您的主要工作负载类型:分布式训练、推理或混合企业流量。计算每个机架所需的带宽和总交换矩阵容量。评估您的团队对 Cumulus Linux 与 NX-OS 的操作熟悉程度。评估您对厂商特定优化和开放标准的容忍度。核实合规性要求,包括政府合同的 FedRAMP 要求。预测您人工智能集群未来三到五年的增长情况。使用实际工作负载模式对这两个平台进行概念验证测试。您的 AI 就绪基础设施取决于交换机性能与实际运行情况的匹配。NVIDIA 平台为专用 AI 环境提供卓越性能。Cisco 交换机为各种数据中心生态系统提供灵活性。运行受控基准测试,测量特定流量配置文件下的吞吐量、延迟和拥塞情况。 最终的决定需要在满足当前性能需求和确保长期架构灵活性之间取得平衡。您的数据中心架构应体现贵组织的战略方向。选择既能满足您当前人工智能集群需求,又能适应未来增长的平台。 您的AI架构选择取决于您的生态系统战略。NVIDIA平台凭借其卓越的原生RDMA和缓冲区管理能力,在紧密集成的AI架构中表现出色。NVIDIA Spectrum-4 ASIC的动态缓冲区分配功能可显著提升您的AI工作负载。NVIDIA交换机可最大限度地降低分布式训练的尾延迟。Cisco Nexus方案则在多厂商环境中提供了更大的灵活性。Cisco交换机内置UEC合规性,确保您的网络保持开放。您必须根据每个平台的优势评估您的数据中心需求。合适的AI就绪型基础设施取决于您的规模、生态系统和合规性需求。评估您的AI工作负载特性并运行概念验证来验证您的选择。NVIDIA架构可为专用AI集群提供峰值性能。Cisco网络支持具有多样化数据流的异构环境。对于以NVIDIA为中心的环境,此架构选择可确保您的AI架构获得最佳性能。 常问问题哪个平台在人工智能训练工作负载方面性能更佳?NVIDIA SN5600 通过 Spectrum-X 优化和自适应路由,在专用 AI 环境中表现出色。其动态缓冲区可有效吸收微突发流量,从而最大限度地减少分布式训练期间的尾延迟。思科产品虽然吞吐量与之相当,但需要针对 AI 特有的流量模式进行更多手动调优。最终哪种方案更适合您的工作负载规模,取决于您的具体需求。我可以将这两款交换机集成到现有的多厂商网络中吗?Cisco Nexus G200 为异构环境提供了卓越的灵活性。其符合 UEC 标准且基于标准的拥塞控制功能可与第三方设备无缝互操作。NVIDIA 交换机在完整的 NVIDIA 生态系统中集成效果最佳。您对厂商锁定的容忍度应作为决策依据。每次切换角色后,我应该获得哪些管理经验?NVIDIA 提供 Cumulus Linux,带来熟悉的基于 Linux 的操作系统环境。您可以使用标准的 DevOps 工具实现交换机的自动化。Cisco 提供 NX-OS,它拥有网络工程师已经熟悉的命令行界面。您的团队对这两个平台的操作熟悉程度越高,培训成本和运维风险就越低。这些交换机在处理拥塞控制方面有何不同?NVIDIA 在 Spectrum-4 ASIC 中直接实现了自适应路由,无需 CPU 干预即可动态地绕过拥塞路径重新路由流量。Cisco 则依赖于 DCQCN 和显式拥塞通知阈值。您可以通过 NX-OS 配置这些机制,并调整参数以匹配您的特定工作负载特性和网络拓扑结构。哪款交换机更能支持未来标准的演进?思科将 Nexus G200 定位为面向统一通信 (UEC) 的就绪型产品,随着行业标准的成熟,确保您的网络面向未来。NVIDIA 则专注于 Spectrum-X 优化,通过其专有增强技术,在当下即可提供卓越的性能。您的长期基础设施愿景将决定哪种方案最符合您的数据中心架构策略。
  • 希捷 E​​xos X18 12TB 硬盘评测:规格、性能和企业级应用案例
    希捷 E​​xos X18 12TB 硬盘评测:规格、性能和企业级应用案例
    August 23, 2026
    希捷 E​​xos X18 12TB 硬盘评测:规格、性能和企业级应用案例如果您正在为服务器、RAID阵列、数据中心或大型存储系统选择硬盘,容量本身不应成为您决策的唯一依据。您还需要考虑接口兼容性、持续性能、工作负载需求、记录技术、可靠性以及硬盘在其使用寿命期间的运行情况。  这 希捷 E​​xos X18 12TB 这款硬盘正是为此类环境而设计的。在本评测中,您将了解这款硬盘的功能,ST12000NM000J SATA 型号的纸面性能表现,它在企业级存储架构中的定位,以及在什么情况下选择它而不是消费级或 NAS 专用硬盘更合适。 希捷 E​​xos X18 12TB ST12000NM000J 是一款 3.5 英寸企业级 SATA 硬盘,容量为 12TB,转速为 7200 RPM,拥有 256MB 缓存、CMR 记录、氦气密封装以及 SATA 6Gb/s 接口。它专为高容量企业级存储工作负载而设计,适用于服务器、RAID 系统、云存储和数据中心环境。 希捷 E​​xos X18 12TB:主要规格在决定这款企业级硬盘是否适合您的系统之前,您应该首先核实其确切型号。AILINK100 产品页面涵盖了 ST12000NM000J,即 12TB Exos X18 的 SATA 版本。希捷的文档也将 ST12000NM000J 认定为 12TB SATA 6Gb/s 标准型号。 规格希捷 E​​xos X18 12TB ST12000NM000J产品系列希捷 E​​xos X18模型ST12000NM000J容量12TB外形尺寸3.5英寸界面SATA 6Gb/s主轴转速7200 转/分缓存256MB录音技术心磁共振驱动设计氦气密封持续转移率最高可达约 270 MB/秒年度工作量评级每年最多 550TB平均故障间隔时间最多可达 250 万小时 以上数据基于AILINK100的最新产品信息和希捷Exos X18的文档。实际部署时,批量订购前务必核实确切的部件号、固件版本、接口、扇区格式和服务器兼容性。 Seagate Exos X18 12TB 硬盘是为哪些用途而设计的?Exos X18 属于希捷的企业级硬盘产品线,而不是面向消费者的存储产品线。在建设基础设施时,这种区别至关重要。当您需要以下组合时,通常会选择 12TB 企业级硬盘:高存储密度连续运行可预测的持续表现RAID 或大型存储阵列企业服务器兼容性高年度工作负荷能力大规模部署经济学 希捷的文档将 Exos X18 系列定义为企业级硬盘,并列出了其功能,包括氦气密封结构、CMR 记录、PowerChoice 空闲电源技术、PowerBalance 电源/性能技术和热插拔支持。对您而言,关键在于:Exos X18 12TB 的设计初衷是成为存储基础设施的一部分,而不仅仅是一款大容量桌面硬盘。 希捷 E​​xos X18 12TB 性能评测7200 转/分,提供稳定的企业级硬盘性能Exos X18 12TB 的运行转速为 7,200 RPM。但这并不意味着它在延迟或随机I/O性能方面可以与NVMe SSD相提并论。你不应该期望企业级硬盘拥有SSD那样的响应速度。 相反,它的优势在于以下两方面的平衡:大容量顺序吞吐量企业工作负载能力每TB成本长时间运行对于以顺序读写为主的工作负载、大容量存储、备份、媒体存储库、数据湖和其他面向容量的应用来说,这种设计比每TB都使用高级SSD容量要合理得多。 持续传输速度最高可达约 270 MB/sSATA Exos X18 文档列出了持续传输性能,最高可达约 270 MB/s,具体取决于容量和运行条件。评估这个数字时,要考虑到工作量。如果您的应用主要由以下几点构成:顺序文件传输备份和恢复大型数据集归档工作负载视频库批量数据存储高容量企业级硬盘可以作为有效的存储层。如果您的工作负载需要极低的延迟或非常高的随机 IOPS,则应该考虑企业级 SSD 或 NVMe 存储。 为什么 CMR 对 Exos X18 12TB 如此重要在为企业存储系统选购硬盘时,需要检查的最重要规格之一就是记录技术。Exos X18 采用传统磁记录 (CMR) 技术。希捷的产品文档明确指出 X18 系列采用 CMR 技术。这为什么重要?如果您正在构建 RAID 阵列或其他写入密集型存储系统,可预测的写入行为至关重要。对于持续稳定的写入行为比通过其他记录技术最大化面密度更为重要的工作负载,CMR 硬盘通常是首选。 因此,如果您正在评估硬盘的以下用途,Exos X18 12TB 可能是一个明智的选择:RAID存储企业文件服务器备份系统大型存储阵列数据中心容量等级 希捷 E​​xos X18 12TB 是 CMR 还是 SMR?希捷 E​​xos X18 12TB ST12000NM000J 是一款 CMR 硬盘,而非 SMR 硬盘。希捷官方 Exos X18 文档中已将传统磁记录 (CMR) 列为该系列产品的特性之一。在 RAID 或企业存储环境中部署多个 HDD 之前,这是需要验证的重要一点。 氦气密封设计:为何至关重要Exos X18 采用氦气密封驱动设计。希捷将氦气密封架构列为 Exos X18 系列的核心特性之一。与充气式设计相比,实际目标是降低内部盘片和磁头所受到的阻力,从而有助于提高存储密度和电源效率。对于单个硬盘来说,价格差异可能不是主要的购买因素。然而,对于包含数十个或数百个驱动器的存储系统而言,功率和密度上的微小差异可能会变得意义重大。这就是为什么企业级硬盘设计需要从系统层面进行评估,而不是仅仅关注容量和转速的原因之一。 希捷 E​​xos X18 12TB 工作负载和可靠性AILINK100 清单中列出的 ST12000NM000J 配置的年工作负载额定值高达 550TB/年,MTBF 为 250 万小时。这些数据在比较企业级硬盘时很有用,但您应该正确解读它们。平均故障间隔时间(MTBF)并非预测单个硬盘的运行时间将达到250万小时,而是一种用于产品和车队层面评估的统计可靠性指标。同样,年度工作负载评级应该与预期的存储流量进行比较。例如,如果您的服务器执行频繁备份、大数据传输、分析工作负载或其他高容量操作,估算预期的年度写入和读取数据量可以帮助您确定企业级 HDD 是否合适。 希捷 E​​xos X18 12TB 硬盘适合服务器吗?是的,前提是接口、扇区格式、固件和物理兼容性与您的服务器或存储控制器相匹配。Exos X18 专为企业环境而设计,希捷在 X18 系列中同时提供 SATA 和 SAS 版本。对于特定的 ST12000NM000J,您看到的是 SATA 6Gb/s 版本。购买前请检查:您的服务器背板是否支持SATA 6Gb/s?RAID控制器是否支持该硬盘?是否支持 3.5 英寸规格?您的服务器是否支持该硬盘的容量?该扇区格式与您的存储软件兼容吗?服务器厂商是否将该硬盘或同等型号的硬盘列为支持的硬盘型号?这一点对于企业采购尤为重要,因为物理兼容的硬盘并不一定适用于所有服务器平台。 希捷 E​​xos X18 12TB 适合做 RAID 吗?Exos X18 专为企业级存储环境而设计,当 RAID 控制器、服务器、背板和固件配置支持该硬盘时,可将其用作基于 RAID 的存储架构的一部分。AILINK100 特别针对 RAID 系统和企业级存储工作负载,将 ST12000NM000J 定位为 RAID 系统和企业级存储工作负载。但是,对于 RAID 部署而言,您应该评估的不仅仅是硬盘本身。考虑:RAID 级别驱动器数量控制器兼容性热备策略重建时间备份策略失效域设计预期工作量所需可用容量例如,增加 12TB 硬盘的数量可以提供大量的原始容量,但 RAID 配置决定了有多少容量可供您的应用程序实际使用。换句话说,每块硬盘 12TB 并不意味着 RAID 配置后每块硬盘有 12TB 的可用存储空间。 SATA 与 SAS:请确保选择正确的 Exos X18 型号这是最重要的购买考虑因素之一。Exos X18 系列包含不同的接口和型号。对于 12TB 的存储介质,希捷的文档中指出:ST12000NM000J — SATA 6Gb/sST12000NM004J — SAS 12Gb/s此外,还有型号不同的 SED 和 SED-FIPS 变体。因此,如果您的存储系统需要 SAS,则不应仅仅因为容量正确就自动订购 SATA ST12000NM000J。同样,如果您的服务器是围绕 SATA 设计的,那么在切换接口之前,您应该确认是否实际支持 SAS 型号。 快速比较要求ST12000NM000JST12000NM004J容量12TB12TB界面SATA 6Gb/sSAS 12Gb/s典型部署SATA服务器/存储系统SAS企业级存储系统是同一型号吗?NoNo直接替换仅当系统支持时仅当系统支持时希捷官方文档应该是您获取型号级别规格的最终参考资料。 哪些人应该考虑购买希捷 Exos X18 12TB 硬盘?当您需要大容量 HDD 存储且您的基础架构支持 SATA 企业级硬盘时,该驱动器尤其适用。1. 企业文件服务器如果您需要大量共享业务数据,12TB 的容量可以帮助提高存储密度,而无需将所有工作负载迁移到 SSD。 2. 备份和灾难恢复存储对于备份存储库而言,容量和每TB的成本通常比超低延迟更重要。因此,如果整体备份架构设计得当,Exos X18 可以作为高容量存储层。 3. RAID 存储阵列CMR 记录和面向企业的规格使该驱动器适用于大型 HDD 阵列,但需满足控制器和平台兼容性要求。 4. 数据中心存储如果您要管理大量的硬盘驱动器,容量密度、工作负载等级、电源效率和可预测的运行将成为重要的购买标准。Exos X18 的企业级定位和氦气密封架构是围绕这种环境而设计的。 5. 云和超大规模存储Exos X18 系列产品定位为企业级和超大规模存储应用。但是,对于大型部署,您应该评估整个存储平台,而不是单独选择驱动器。 哪些人不应该购买Exos X18 12TB?如果你的主要需求是极低的延迟或极高的随机 I/O 性能,那么你应该三思而后行。对于以下工作负载:高交易量数据库AI训练暂存存储高IOPS虚拟化层低延迟应用存储对性能要求极高的元数据工作负载企业级 NVMe SSD 或其他企业级 SSD 可能更合适。Exos X18 的优势在于高容量企业级 HDD 存储,而不是在对延迟敏感的工作负载中取代 NVMe SSD。 希捷 E​​xos X18 12TB 对比消费级硬盘为什么你会选择企业级硬盘而不是传统的台式机硬盘?答案是目标工作负载。消费级硬盘通常针对经济高效的个人计算和通用存储进行了优化。Exos X18 的设计充分考虑了企业级需求,例如:全天候运营年度工作量高大规模存储RAID环境数据中心部署企业可靠性要求希捷官方文档列出了 Exos X18 系列面向企业的各项技术和功能,包括 CMR、氦气密封结构、PowerChoice、PowerBalance 和热插拔支持。 如果您正在构建业务关键型存储阵列,那么正确的比较并非简单地:“哪款12TB硬盘最便宜?” 更好的问题是:“哪款 12TB 硬盘适合我的工作负载、存储架构和预期运行环境?” 希捷 E​​xos X18 12TB:主要优势和局限性优势高达 12TB 的容量: 您可以大幅增加存储容量,同时保持硬盘数量在可控范围内。企业级设计: Exos X18 是为企业存储应用而设计的,而不是为普通桌面工作负载而设计的。CMR记录: 适用于对写入行为一致性要求较高的应用场景。7200 转/分: 在硬盘性能、容量和运行效率之间取得了合理的平衡。256MB 缓存: 为存储工作负载提供额外的缓冲。氦气密封结构: 支持 Exos X18 系列的高密度设计。SATA 6Gb/s接口: 使 ST12000NM000J 适用于兼容的基于 SATA 的服务器和存储系统。 局限性硬盘延迟:在延迟和随机 I/O 方面,它无法与企业级 NVMe SSD 竞争。接口特定兼容性:您必须确认您的服务器或控制器支持 SATA 接口。12TB 的原始容量并不总是 12TB 的可用容量:RAID、文件系统格式化和系统开销会减少可用容量。企业级硬盘声学和振动:对于安静的家庭或办公环境而言,数据中心级别的硬盘可能并非理想之选。 服务器项目应该如何选购 Seagate Exos X18 12TB?如果您购买一个硬盘用于评估,那么流程相对简单。对于企业或数据中心部署,您应该采取不同的采购方式。步骤 1:确认准确的零件编号不要仅仅通过搜索“Exos X18 12TB”来下单。请确认您是否需要:ST12000NM000J SATA或其他型号,例如:ST12000NM004J SAS希捷的官方文档证实,这些是不同的接口版本。 步骤二:确认服务器兼容性请提供您的:服务器品牌服务器模型RAID控制器背板现有硬盘型号所需容量界面这样一来,您的供应商就可以在您批量购买之前检查兼容性。 步骤 3:计算可用 RAID 容量如果您要购买多个 12TB 硬盘,请根据您的 RAID 级别计算可用容量,而不是简单地将 12TB 乘以硬盘数量。 第四步:考虑您的年度工作量将您的预期工作负载与硬盘的额定工作负载进行比较。AILINK100 将 ST12000NM000J 列为年工作负载额定值高达 550TB/年。 第五步:大规模部署前索取样品对于规模较大的企业项目,在实际服务器和 RAID 环境中测试样品硬盘是一种明智的采购做法。您可以验证:驱动检测RAID 控制器兼容性固件行为智能信息持续表现温度重建行为这比购买整批产品后才发现兼容性问题要安全得多。 最终结论:希捷 Exos X18 12TB 值得考虑吗?如果您优先考虑的是高容量企业级 SATA 存储而不是 SSD 级别的延迟,那么 Seagate Exos X18 12TB ST12000NM000J 是一个不错的选择。如果您有以下需求,则应考虑:12TB 企业级硬盘容量7200 转/分性能CMR记录SATA 6Gb/s 连接兼容 RAID 的存储服务器或数据中心部署高年度工作负荷能力大规模存储密度 如果您的工作负载以随机 I/O、对延迟敏感的应用程序或非常高的 IOPS 要求为主,则应考虑企业级 SSD 或 NVMe 替代方案。 最重要的是,不要仅仅根据容量选择硬盘。下单前,务必确认硬盘的具体型号、接口、控制器兼容性、工作负载、RAID 设计以及部署环境。 具体来说,AILINK100 目前将 ST12000NM000J 列为 12TB Seagate Exos X18 企业级 SATA 硬盘,转速 7200 RPM,256MB 缓存,支持 CMR 记录,并采用 SATA 6Gb/s 接口。您可以通过产品页面查询服务器或存储项目的供货情况、价格和兼容性信息。 关于希捷 Exos X18 12TB 的常见问题希捷 E​​xos X18 12TB 是一款好的企业级硬盘吗?是的。Exos X18 是专为大规模存储环境设计的企业级硬盘系列。ST12000NM000J 提供 12TB 容量、7200 RPM 转速、SATA 6Gb/s 连接、CMR 记录功能以及面向企业级工作负载的规格。 希捷 E​​xos X18 12TB 是 CMR 吗?是的。Exos X18 系列采用常规磁记录 (CMR) 技术,包括 12TB ST12000NM000J 型号。 希捷 E​​xos X18 12TB 适合组建 RAID 吗?是的,前提是服务器、RAID控制器、背板、固件和硬盘接口都兼容。它面向企业级存储和RAID应用。 ST12000NM000J 是 SATA 还是 SAS?ST12000NM000J 是 12TB SATA 6Gb/s 型号。12TB SAS 型号为 ST12000NM004J。 希捷 E​​xos X18 12TB 的速度有多快?SATA Exos X18 文档规定,其持续传输性能最高可达约 270 MB/s,具体取决于型号和操作条件。 Exos X18 比 SSD 好吗?并非总是如此。Exos X18 更适合高容量、高性价比的企业级 HDD 存储,而企业级 SSD 通常更适合需要极低延迟和高随机 IOPS 的工作负载。 Exos X18 12TB 可以在服务器中使用吗?是的,前提是服务器、背板、存储控制器、固件、外形尺寸、接口和扇区格式都支持该特定硬盘。对于 ST12000NM000J,您需要兼容的 SATA 存储架构。 哪里可以买到希捷Exos X18 12TB ST12000NM000J?AILINK100目前提供希捷Exos X18 12TB ST12000NM000J,并提供产品咨询和企业存储采购支持。对于规模较大的部署,建议您提供服务器或存储配置信息,以便在购买前确认兼容性。
  • 2026 年最佳企业级可扩展存储硬盘
    2026 年最佳企业级可扩展存储硬盘
    August 13, 2026
    到 2026 年,您需要最好的企业级硬盘才能高效扩展庞大的服务器基础设施。高密度云存储环境需要经过验证的硬盘,例如…… 希捷 E​​xos X系列、西部数据金牌系列和东芝MG系列。这些企业级硬盘能够应对数据中心中高强度、持续性的工作负载。您的采购策略必须评估除每TB前期成本之外的关键指标。您应该将硬盘的工作负载等级与系统需求相匹配,并为每个服务器机箱选择SAS或SATA接口选项。现代大容量机械硬盘可确保全年持续运行的可靠性。选择合适的硬件可以保护您在可扩展存储方面的投资。 要点总结选择希捷 Exos 或 WD Gold 等高容量硬盘,可以高效地扩展您的数据中心。根据您的服务器机箱和工作负载要求,选择合适的 SAS 或 SATA 硬盘接口。将高速固态硬盘与机械硬盘结合使用,打造均衡的分层存储系统。氦气密封驱动设计可减少内部气体摩擦,并将整体功耗降低 50%。 2026 年最佳企业级硬盘您需要性能卓越的企业级硬盘来管理基础设施中不断增长的业务量。选择高容量硬盘至关重要。 企业存储硬盘 硬盘驱动器使您的数据中心能够实现最佳效率。现代服务器机箱依赖于专为应对繁重持续工作负载而设计的专用硬盘驱动器。 适用于大数据密度的顶级硬盘领先的制造商提供专为严苛机架环境设计的卓越服务器硬盘选项。希捷通过其 Mozaic 3+ HAMR 平台提供最大服务器硬盘容量,例如 Exos M ST32000NM000K 硬盘容量高达 32TB。您还可以选择容量为 30TB 的希捷 Exos M ST30000NM004K SATA 硬盘或容量为 24TB 的 Exos X24 ST24000NM007H SAS 硬盘。西部数据推出 WD Gold 26TB 硬盘,进一步拓展了企业级硬盘产品线。该硬盘采用 ePMR 和 OptiNAND 技术。与此同时,东芝推出 MG11 系列 24TB 硬盘,采用 FC-MAMR 技术并配备 1GB 缓存。下表对比了这两款顶级服务器硬盘的关键规格:模型容量界面工作负荷评级旋转速率希捷 E​​xos M ST32000NM000K32TBSATA 6Gb/s每年550 TB7200 转/分希捷 E​​xos M ST30000NM004K30TBSATA 6Gb/s每年550 TB7200 转/分WD Gold 26TB26TBSATA 6Gb/s每年550 TB7200 转/分东芝MG1124TBSATA 6Gb/s每年550 TB7200 转/分每款企业级硬盘都包含关键的企业级功能,例如旋转振动保护和 5 年质保。这些企业级功能可确保在单个服务器机箱内安装数十块硬盘时系统依然稳定运行。 主流车型性能对比评估机械硬盘速度有助于您将每块服务器硬盘与您的运行工作负载相匹配。读写速度因技术而异,正如制造商测试和独立评估所示:驱动模式额定速度独立顺序读取独立顺序写入希捷 E​​xos M 30TB275 MB/s292 MB/s289 MB/s西部数据金牌 26TB288 MiB/s(约 302 MB/s)283–285 MB/s未报告东芝 MG11 24TB295 MiB/s(约 309 MB/s)有限数据未报告顺序吞吐量仅代表硬盘整体性能的一个方面。在为混合云存储应用配置服务器时,您还必须评估随机访问 IOPS。与……相比,标准机械硬盘的随机 IOPS 表现一般。 适用于数据中心的企业级固态硬盘然而,高密度服务器硬盘对于经济高效的大容量数据存储仍然至关重要。如图所示,转速为 7200 转/分的希捷 IronWolf Pro 22TB 硬盘的 4K 随机读取 IOPS 约为 210,4K 随机写入 IOPS 约为 230。希捷 Exos X20 18TB 硬盘的 4K 随机读取 IOPS 约为 190,4K 随机写入 IOPS 约为 210。而转速为 5400 转/分的西部数据 Red Plus 14TB 硬盘的 4K 随机读取 IOPS 约为 150,4K 随机写入 IOPS 约为 170。将高性能服务器硬盘与固态硬盘缓存层集成,可构建均衡的存储架构。高级企业级功能(例如热节流)可控制高密度机架中的硬盘健康状况。此外,硬件加密等企业级功能可保护活跃服务器部署中的敏感数据。选择最佳的企业级硬盘可确保您的企业级硬盘集群具备可扩展的容量、长期的耐用性和稳定的吞吐量。 企业级硬盘的关键选择标准在为存储阵列购买高容量企业级存储硬盘之前,必须评估关键技术因素。选择正确的硬盘架构可以避免系统瓶颈,并最大限度地提高物理密度。 容量、接口和转速接口选择决定了整体系统拓扑结构并驱动通信速度。企业基础设施主要依赖于串行连接SCSI (SAS) 和串行ATA (SATA) 协议。SAS 控制器或背板可以接受 SATA 硬盘,但 SATA 控制器永远不会接受 SAS 硬盘。这条硬件设计规则适用于所有机架式机箱的连接匹配。双端口 SAS 企业级硬盘为关键任务操作提供多路径冗余,而 SATA 则为海量数据提供经济高效的连接。当工作负载需要亚毫秒级访问时间时,数据中心应选择企业级 SSD。然而,机械硬盘在每 TB 存储成本方面表现更佳。主轴转速直接影响访问延迟和顺序吞吐量,如下表所示:主轴转速班级优势最适合7200 转/分中线/近线(3.5英寸)容量最高,每TB成本最低,功耗低备份、归档、大容量冷存储10,000 转/分企业版(2.5)速度、容量、密度之间的平衡通用和中等性能工作负载15,000 转/分企业绩效(2.5)最低硬盘延迟,最高硬盘IOPS传统性能需求将主轴转速从 7,200 RPM 提升至 10,000 RPM 可将平均旋转延迟从 4.17 毫秒降低至 3.00 毫秒。更高的转速会增加高密度机箱配置中的硬盘功耗和发热量。因此,近线 7,200 RPM 硬盘可提供大型服务器存储池所需的主要高密度容量。评估耐久性规格可确保您的服务器硬盘配置能够处理预期的写入流量,而不会发生意外故障。工作负载评级通过总写入字节数 (TBW) 或每日硬盘写入次数 (DWPD) 来衡量耐久性。使硬盘耐久性与每日写入量相匹配可保持服务器的整体稳定性。 通电时间、平均故障间隔时间和可靠性特性数据中心系统需要不间断运行,因此硬盘硬件的耐用性至关重要。现代企业级硬盘通过严格的制造标准来满足持续运行的需求。系统管理员会在硬盘运行约 25,000 至 30,000 小时(POH)后开始制定更换计划,以防止意外的硬件停机。您可以使用既定的可靠性公式来评估统计故障概率:可靠性指标公式对选拔的影响MTBF(平均故障间隔时间)两次故障之间的总运行时间 / 故障次数数值越高,表示预期使用寿命越长,停机风险越低。年度工作量率(终身写作量 + 终身阅读量)*(8760 / 终身活跃小时数)超过额定传输极限会加速磨损并使保修失效。硬件设计融入了企业级特性,以保护高密度多驱动器阵列。集成的旋转振动传感器可检测外部机箱运动。内部控制器会调整执行器位置,以抵消相邻驱动器单元的动态干扰。限时错误恢复 (TLER) 将坏扇区恢复尝试次数限制在大约 7 秒内,并立即通知硬件 RAID 控制器以保持阵列稳定性。这些企业级特性优化了硬盘错误处理,同时在高负载下保持服务器响应速度。专用的固件队列协议提升了并行命令执行期间的多客户端性能。诸如主动磁头停放、高级数据保护算法和自动电源管理等企业级特性降低了运行风险。选择具备强大企业级特性的硬件可确保整个服务器硬盘基础架构的运行可靠性。 工作负载匹配和驱动架构SAS 与 SATA 接口要求服务器硬盘的选择必须直接取决于具体的运行需求。企业级 SAS 接口硬盘支持高达 12-24 Gbps 的吞吐量,并提供高级错误检测和纠正功能。相比之下,SATA 服务器硬盘的传输速度最高可达 6 Gbps,并具备基本的错误纠正功能。SAS 服务器硬盘适用于需要无延迟的多线程事务处理的关键任务型数据库、电子商务平台和虚拟机集群。当工作负载需要即时数据访问时,存储管理员会部署固态硬盘 (SSD)。将高速 SSD 阵列与近线存储相结合,可以构建均衡的拓扑结构。评估硬盘耐久性可以防止在持续写入环境中出现硬件过早故障。读取密集型应用所需的耐久性等级较低,约为 1 DWPD 或更低。混合用途工作负载需要 3 DWPD 的耐久性才能进行事务处理。写入密集型数据摄取管道需要 10 DWPD 的耐久性才能承受大量的每日写入。这种策略性的分层设计可以优化所有存储节点的整体系统性能。 氦气技术和执行器创新氦气密封通过消除内部空气湍流来提高硬盘容量。将惰性气体密封在机箱内,使得标准的 3.5 英寸服务器硬盘框架中可以容纳九个超薄盘片。与空气填充硬盘设计相比,采用氦气密封的东芝 MG08 系列硬盘每 GB 功耗降低约 50%。降低功耗不仅可以扩大机架容量,还能确保每个服务器机箱内的安全工作温度。先进的企业级功能可保护磁头位置免受持续振动的影响。驱动器创新技术确保磁头在密集排列的磁盘上保持精准定位。双级驱动器结合了 200 纳米的毫驱动器和 100 纳米的微型驱动器,实现紧密的磁道对准。诸如 Seagate MACH.2 之类的多驱动器组件可将 IOPS 性能提升一倍,并提高顺序读写性能,同时提供高达 480MB/s 的持续读取速度。这些专为企业级应用而设计的特性,在机械服务器硬盘的卓越性能与固态硬盘的辅助缓存之间实现了平衡。每块高密度服务器硬盘都配备了现代企业级特性,从而确保了服务器的高可靠性。 在可扩展基础架构中部署驱动器分层存储系统内的集成您可以将数据中心级企业级固态硬盘 (SSD) 与大容量企业级存储硬盘相结合,构建可扩展的数据存储基础架构。现代混合架构在计算边缘部署高速固态硬盘或专用企业级 SSD。集成的企业级功能使该层能够将快速突发写入路由到高速 SSD 缓存层。因此,您的存储架构能够以最小的延迟处理传入的读写请求,同时保护主硬盘阵列。您的存储控制器会将较旧的数据文件移动到大型服务器硬盘池中进行长期保留。例如,大型 AI 训练集群会在 6,080 个 GPU 上部署 46 PB 的 NVMe 缓存,以在运行期间最大限度地提高工作负载性能。检查点任务会将临时数据写入高速闪存,然后再将这些文件迁移到大型服务器硬盘阵列。这种分层部署方式既能保护写入耐久性,又能优化整个云存储网络的总驱动器容量。 机箱密度、散热管理和扩展性高密度机箱布局需要适当的环境控制,以保护服务器硬件免受物理磨损。在高密度机架式机箱内安装服务器硬盘会导致高热负荷和声振动。剧烈的机械振动会降低硬盘读取精度,并迫使内部执行器不断重新校准。您必须监控服务器硬盘的写入耐久性指标,并启用专门的企业级功能,以在持续运行负载下维持系统性能。您可以通过采用有针对性的圈舍管理方法来减轻物理压力:设置风扇转速曲线,使空闲硬盘温度保持在 45°C 以下。使用防震安装托架可降低 12-18 分贝的振动。启用顺序启动定时器,以消除瞬态上电脉冲尖峰。采用精密浸没式液冷技术,使硬盘温度均衡,保持硬盘的最佳性能。连接网络附加存储阵列 (NAS) 可在不降低硬盘寿命的情况下扩展整体容量。集成的固件协议可管理后台磁头停放和巡检读取,以维护阵列的完整性。现代服务器设备采用先进的企业级功能来隔离多硬盘机箱振动。部署转速匹配的每块服务器硬盘可确保在不断扩展的基础架构中实现可预测的服务器硬盘性能。 选择最佳 企业级硬盘 这需要在高容量和长期硬件可靠性之间取得平衡。您必须评估初始采购成本,同时考虑持续的功耗和工作负载需求。现代数据基础设施依赖于将每个服务器硬盘与您的实际工作负载需求相匹配。您应该平衡使用高密度企业级硬盘和闪存,以优化系统吞吐量。下单前,您必须确认所有硬件完全兼容。请验证您的主机总线适配器是否支持您选择的驱动协议。此外,请确保您的服务器背板和机箱满足散热和振动要求。在部署前检查这些服务器要求,可以保护您的基础设施投资,并确保不间断的运行性能。 常问问题企业级大容量存储硬盘应该选择 SAS 还是 SATA?对于需要双端口冗余和高达 12-24 Gbps 传输速度的关键任务型工作负载,应选择 SAS 接口。对于传输速度高达 6 Gbps 且经济高效的大容量数据存储,应选择 SATA 接口。请确认您的主机总线适配器支持所选接口。企业级数据中心固态硬盘如何与机械硬盘协同工作?您可以将高性能企业级固态硬盘 (SSD) 与机械硬盘结合使用,构建分层架构,用于数据中心。高速固态层负责处理突发写入和频繁读取请求。然后,系统将冷数据传输到机械硬盘,以实现可扩展的长期存储。为什么高密度服务器硬盘要采用氦气技术?密封氦气可降低机箱内部气体摩擦和空气湍流。这种设计使制造商能够在标准的 3.5 英寸硬盘框架内安装多达九个超薄盘片。该技术可在保持安全工作温度的同时,将每 GB 的功耗降低约 50%。RAID阵列中的限时错误恢复(TLER)是什么?限时错误恢复功能将硬盘坏扇区恢复尝试次数限制在约 7 秒内。硬盘控制器会迅速将扇区问题通知硬件 RAID 控制器。此过程可防止硬盘从阵列中掉线,并在高负载运行下保持存储系统的整体稳定性。
  • 了解如何选择合适的DDR5 ECC服务器内存模块
    了解如何选择合适的DDR5 ECC服务器内存模块
    August 05, 2026
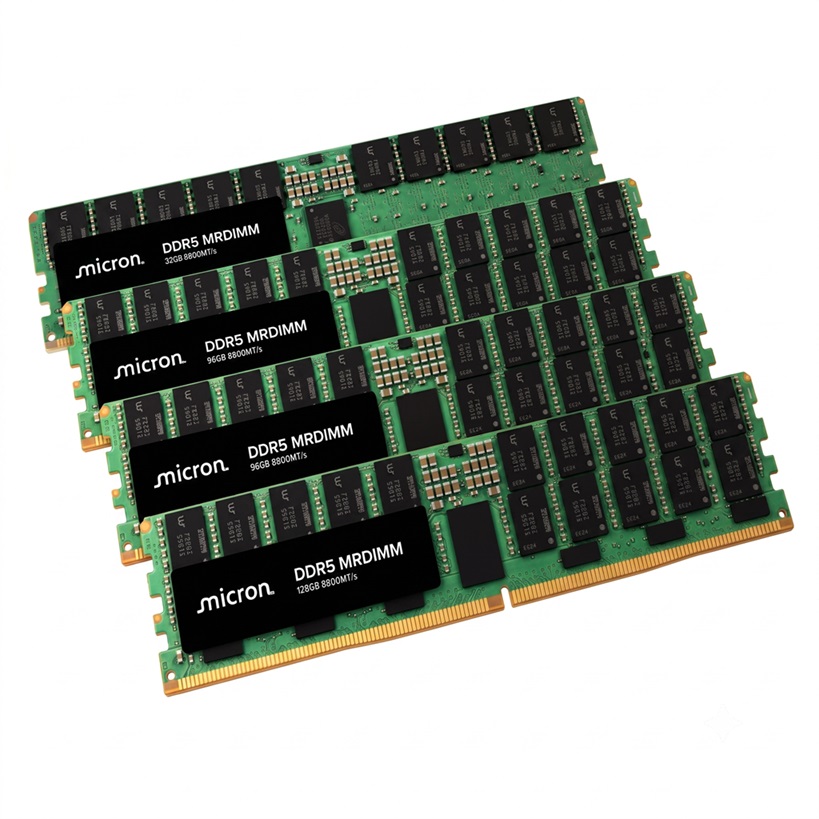
    选择最佳的DDR5内存需要评估模块架构、传输速度、每个插槽的容量、电压效率以及企业工作负载需求。现代高性能服务器依赖于先进的内存子系统来支持诸如Intel Xeon Scalable和AMD EPYC等平台。部署 DDR5服务器内存模块 为关键任务型数据中心运营提供卓越的带宽和超低延迟。 服务器内存升级可立即提升系统可靠性和总线数据路径完整性。新一代 DDR5 技术集成了片上纠错功能,可防止意外硬件停机。通过计划性服务器升级,您可以保护企业基础设施。合适的内存密度可确保在持续高负载计算下实现最佳企业性能。 要点总结升级到 DDR5 服务器内存可以提高系统带宽,并通过高效的 1.1V 运行降低能耗。选择 RDIMM 或 MRDIMM 等现代模块架构可以优化繁重企业工作负载的数据传输速度。先进的纠错功能可保护数据完整性,防止数据中心出现代价高昂的系统停机。对称地填充内存通道可确保达到峰值处理速度并保持服务器整体稳定性。了解DDR5模块类型和架构选择正确的服务器内存模块架构可确保企业服务器的运行稳定性。您需要了解物理服务器内存设计的差异,才能最大限度地利用现代硬件投资。不同的企业工作负载需要在整个基础架构中选择合适的内存方案,以实现最佳效率。 RDIMM、LRDIMM 和 MRDIMM 的机械结构内存类型关键结构部件运行机制与能力目标应用RDIMM集成寄存器缓冲区缓冲命令、地址和时钟信号,以降低内存控制器的电负载,大约增加一个时钟周期的延迟。标准服务器硬件和高可靠性系统LRDIMM注册时钟驱动器 + 数据缓冲区通过数据缓冲区缓冲控制信号并重新驱动数据线,从而对控制器隐藏原始 DRAM 芯片,以最大限度地提高重载限制。标准服务器硬件和高密度部署MRDIMMDIMM 内存多路复用缓冲器和控制逻辑通过多路复用器同时运行两个通道,有效地将通道吞吐量提高一倍,超过原生 DDR5 速率(例如,在 8800 MT/s 时约为 70.4 GB/s)。人工智能、高性能计算 (HPC) 和下一代服务器平台多路复用双列直插式内存模块 (DIMM) 采用内置多路复用缓冲器和专用控制逻辑,实现双列 DDR5 操作。通过同时管理跨多个内存列的数据流,这些先进的模块突破了标准 DDR5 的速度限制。您可以获得更高的数据吞吐量、更低的延迟、更大的有效容量以及更高的每瓦能效。这些模块在每个周期内向处理器提供 128 字节的数据有效载荷,在连续计算操作期间,其有效载荷能力是标准 DDR5 模块的两倍(标准 DDR5 模块为 64 字节)。MRDIMM 集成了高速复用技术,允许同时访问多个内存条,而不是像标准内存交错那样按顺序处理操作,从而使每个引脚的有效数据速率翻倍,并最大限度地提高带宽。并发 Rank 访问:MRDIMM 架构支持跨 DRAM Rank 对的并发激活和读取,与标准的单 Rank DDR5 操作相比,吞吐量大幅提高。数据流复用:采用专用组件来组合数据通道,有效地将每个引脚的有效数据传输速度提高一倍(例如,将原生 6,400 MT/s DRAM 频率提升至 12,800 MT/s 接口速度)。 评估信道拓扑结构和排序结构双列 (2Rx4) 架构,例如企业级 64GB DDR5 内存条中采用的架构,在信号完整性和扩展性之间实现了最佳平衡。双列结构允许系统架构在保持清晰信号质量的同时,在已插满内存插槽上实现更高的内存密度。系统架构师在设计服务器节点时,还必须评估通道拓扑结构对工作频率的影响。选择均衡的列数设计可以防止在繁重的计算任务期间出现信号衰减,并简化服务器的长期维护。 在英特尔 Eagle Stream 平台上,将通道密度从 1DPC 提升至 2DPC,可将第四代至强可扩展处理器的 DDR5 内存最高运行频率提升至 4400 MT/s,第五代至强可扩展处理器的最高运行频率提升至 4800 MT/s。然而,对于某些额定运行频率低于 4800 MT/s 的中端和入门级处理器 SKU(例如运行频率为 4000 MT/s 或 4400 MT/s 的处理器),过渡到 2DPC 拓扑结构不会造成频率损失。您可以部署 2DPC 配置以直接匹配 1DPC 的运行速度,从而确保在所有企业云环境中实现长期系统可靠性和稳定性能,而不会影响整体总线带宽。将企业工作负载与DDR5内存模块进行匹配现代企业平台需要可扩展的带宽来处理持续的计算操作。使用性能卓越的 DDR5 内存升级服务器节点,可显著提升关键 IT 环境的吞吐量。部署先进的服务器内存模块可提供高性能,并有助于最大限度地提高硬件密度。高密度 DDR5 内存模块可消除内存密集型应用中的数据瓶颈。 DDR5内存速度、延迟和等级配置内存频率直接影响系统延迟和企业整体吞吐量。选择具有低时序特性和优化双列设计的内存模块,可获得最高的内存通道速度。高速 DDR5 内存可提高处理器在复杂工作负载下的内核效率。规格细节内存标准与技术DDR5 PC5-44800速度和带宽5600 MT/s,44800 MB/s外形尺寸和引脚注册式 DIMM (RDIMM),288 针纠错与排名ECC注册,2Rx4电压和时序1.1V,CAS延迟40 为了建立可靠的绩效基准,请考虑以下因素: 三星 M321R8GA0PB0-CWMCJ RDIMM 模块该内存模块运行速度为 5600 MT/s,CAS 延迟为 40 周期。2Rx4 双列架构可平衡服务器主板上的电气负载。1.1V 的工作电压可降低高密度服务器机箱内的发热量,同时保持内存通道的高速运行。高数据吞吐量:运行速度高达 5600MT/s,可为企业工作负载提供快速处理。增强可靠性:集成 ECC 技术通过识别和纠正内存错误来帮助防止系统崩溃。可扩展容量:每个模块提供 64GB 内存,可处理多任务和资源密集型服务器应用程序。企业优化:采用 2Rx4 等级设计,并符合 PC5-44800 标准,可与服务器兼容。 人工智能、数据库和虚拟化的内存容量规划企业应用需要海量数据吞吐量和稳定的内存延迟。部署高速 DDR5 内存可以加速大数据分析流程和数据库查询响应。当系统具备高速 DDR5 内存时,机器学习框架可以更快地处理大型参数。高速 DDR5 内存带宽能够确保处理器核心在密集训练任务期间始终保持满负荷运行。选择 64GB DDR5 内存模块可以让系统管理员最大限度地利用每个插槽的内存空间,同时在繁重的并行工作负载期间保持较低的延迟。虚拟化支持:提供专为企业虚拟化需求量身定制的高密度 64GB 容量。服务器吞吐量:提供 DDR5-5600 的速度,旨在缓解现代服务器平台中的性能瓶颈。电源效率:采用 1.1V 低功耗运行,显著降低服务器机架中的发热量和功耗。 大型数据库引擎需要稳定的延迟特性来处理并发用户查询。合理的容量规划可以避免频繁的磁盘交换,从而提高系统响应速度。虚拟化云平台能够从高密度服务器升级中获益匪浅。精准的内存容量扩展规划可以确保跨虚拟机管理程序保持稳定的虚拟机密度。通过将工作负载需求与高速内存架构相匹配,您可以显著提升企业基础架构的性能。现代 DDR5 内存模块为可扩展的数据中心计算操作提供了理想的基础。 优化服务器通道架构以实现峰值吞吐量要实现服务器峰值吞吐量,需要在现代处理器上合理配置通道。您必须仔细平衡物理内存通道,以最大限度地提高高性能系统的系统带宽。 企业服务器s 依靠均衡的通道配置来处理计算任务,避免出现系统瓶颈。 计算信道人口和容量正确的内存通道配置决定了企业级平台的系统吞吐量。您可以根据严格的处理器指南,系统地配置服务器内存通道,从而优化性能。每个插槽填充 1、2、4、6、8、10 或 12 个内存通道。在每个活动通道上安装相同的内存模块,以保持通道设置的一致性。服务器内每个处理器插槽上的 DIMM 配置必须完全相同。在 NPS2 或 NPS4 设置下,保持所有 NUMA 域的内存配置一致。最大化内存容量可防止在虚拟化或大型数据集处理等内存密集型操作期间出现严重的系统性能下降。增加足够的内存可防止因启用磁盘交换或操作系统分页而导致的系统性能下降。通过匹配每个插槽的通道要求,您可以确保企业级服务器的可靠运行。 跨多DIMM配置管理性能多DIMM配置会在处理速度、延迟和整体功耗之间引入物理上的权衡。现代DDR5内存模块集成了片上电压调节模块,工作电压为1.1V。与DDR4架构的1.2V电压相比,这种设计理论上可节省约15-20%的功耗。 较高的 CAS 延迟值(例如 CL40 到 CL42)会在数据访问开始前引入轻微的时钟周期延迟。视频编码等顺序访问模式可以利用高 DDR5 带宽,并将延迟损失降至最低。相反,实时图像处理等非顺序任务会因延迟增加而受到影响。将 DDR5 DIMM 内存条分割成多个子通道可以优化并发数据流。这种内部并行机制可以隐藏并行操作期间的原始 DRAM 延迟。选择均衡的 DDR5 服务器内存模块可以维持高效的服务器内存架构,从而保持系统的整体稳定性。 DDR5内存的关键可靠性和电源特性数据中心硬件需要在高强度计算负载下保持持续可靠的运行状态。现代企业应用需要强大的保护机制来防止系统崩溃和停机。选择先进的硬件能够为您的云基础设施提供企业级的稳定性和持续的散热控制。 片上纠错和边带纠错技术层面片上ECC边带DRAM总线ECC覆盖范围仅内部DRAM芯片整个数据通路(芯片、PCB、内存控制器)核心目的随着单元尺寸缩小,芯片可靠性得到提升。确保端到端数据完整性运输途中保护没有任何主动传输路径保护纠错能力单比特错误率 (SEC)单错误校正,双错误检测(SEC-DED)新一代DDR5技术在DRAM芯片内部直接引入了单元保护机制。芯片会为每128位数据计算并存储8位内部纠错码。这种机制可以在读取操作期间本地纠正单比特错误。然而,本地纠错方案会忽略传输路径错误。 企业级服务器结合了内部保护和边带纠错码,以确保整个数据路径的安全。这种全总线保护能够修复内存控制器和内存模块之间的传输错误。这些机制的结合提高了硬件可靠性,并在关键任务环境中减少了 18% 的内存相关故障。您可以保护每个活动计算通道上的整体数据完整性。 模块内电源管理集成电路和热效率传统内存模块依赖主板电路进行电压调节。而现代DDR5内存则将电源调节直接转移到内存模块上,使用板载电源管理IC。板载控制器接收5V输入电压,并将其本地降压至1.1V。更短的供电路径:在模块上施加稳压作用可以缩短电气线路长度并降低线路电阻。更快的动态响应:局部电源控制能够快速响应不断变化的处理需求。更严格的电压控制:本地调节可降低电噪声并防止电压损失。将工作电压从 1.2V 降低到 1.1V,与传统标准相比,内存功耗降低了 15%。这种能耗降低可最大限度地减少高密度企业级机箱的发热量。选择高密度 DDR5 内存可降低高密度机架环境中的散热需求。这种智能能源管理可在保持系统最佳性能的同时,优化总体拥有成本。高密度 DDR5 内存为要求严苛的企业级服务器提供卓越的可靠性和能源效率。 您可以通过平衡工作负载需求、密度目标和预算限制来优化服务器内存采购。选择合适的服务器内存模块可确保长期稳定运行。购买 DDR5 硬件之前,必须参考主板的合格供应商列表。未经验证的内存选择会导致初始化停滞和系统自动重启。供应商测试可验证内存芯片在高计算负载下的稳定性。 按计划执行服务器内存升级可提升整体处理性能。部署节能型 1.1V DDR5 组件可降低数据中心机架的功耗和发热量。策略性的内存等级管理可最大限度地提高活动通道的带宽。周密的 DDR5 规划可在关键服务器升级期间保障您的基础架构可靠性。智能升级规划可长期优化您的总体拥有成本。 常问问题为什么企业服务器应该选择DDR5内存?现代服务器需要快速处理繁重的计算任务。部署 DDR5 内存可提升系统总带宽。新一代 DDR5 技术可提高运行可靠性。高效的 1.1V 运行模式可降低整体能耗。服务器内存升级如何提高系统带宽?服务器内存升级可以扩展主板上的活动数据通道。高性能的 64GB DDR5 内存条传输速度高达 5600 MT/s。这种高速传输可以降低高强度并行操作期间的原始内存延迟,从而消除数据中心内严重的性能瓶颈。为什么 RDIMM 内存是关键任务工作负载的最佳 DDR5 内存?RDIMM 内存条可缓冲地址和命令信号,从而降低内存控制器的电负载。选择最佳的 DDR5 内存可确保在多 DIMM 通道配置下保持稳定的信号完整性。这种均衡的服务器内存设计有助于您在不牺牲总线频率的情况下平稳地进行系统升级。双等级模块如何为计划中的服务器升级带来好处?双列 2Rx4 内存模块可在主板走线上平衡容量和信号质量。您可以在最大限度提高每个插槽的内存密度的同时,保持所有已插满内存通道的高 DDR5 内存吞吐量。通过 DDR5 硬件进行战略性服务器升级,可以确保您的基础架构安全可靠。此次硬件升级还能优化长期总体拥有成本。
  • HBA 与 RAID 控制器:哪种更适合现代软件定义存储?
    HBA 与 RAID 控制器:哪种更适合现代软件定义存储?
    May 21, 2026
    如果您最看重灵活性以及与高级软件 RAID 解决方案的集成,那么您应该选择 HBA 卡来实现现代软件定义存储。RAID 卡可提供更高的顺序读写速度、更低的延迟以及卓越的随机 IOPS 性能,如下所示:指标RAID 控制器性能HBA卡性能顺序读取速度最高可达 12 Gb/s依赖于主机系统顺序写入速度最高可达 10 Gb/s依赖于主机系统随机读取IOPS超过 10 万50,000+随机写入 IOPS50,000+20,000+延迟缓存降低了延迟延迟较高部署前,您需要权衡性能、成本和兼容性。这篇博客将为您提供清晰的对比和切实可行的建议。 要点总结在软件定义存储环境中,选择 HBA 可实现灵活性和直接驱动器访问。RAID 控制器提供卓越的性能和数据保护,使其成为关键任务应用的理想选择。评估您的工作负载需求以选择合适的控制器;HBA 适用于现代 SDS,而 RAID 适用于传统设置。部署 HBA 或 RAID 解决方案之前,务必检查兼容性和固件支持,以确保最佳性能。在选择存储解决方案时,应考虑总拥有成本,包括维护和电力消耗。HBA卡与RAID卡:主要区别 什么是HBA?您可以使用主机总线适配器 (HBA) 将服务器连接到多个存储设备。HBA 卡充当直通控制器,允许您的操作系统直接访问每个连接的驱动器。如果您想使用软件 RAID 解决方案(例如 ZFS 或 vSAN),这种直接访问至关重要。在企业级存储中,HBA 卡可帮助您高效地管理大量驱动器。您经常会在数据中心看到 HBA 卡,因为在这些数据中心,灵活性和与高级软件定义存储的兼容性至关重要。 什么是RAID卡?RAID 卡(也称为 RAID 控制器)管理多个硬盘,并将它们合并成一个虚拟硬盘。RAID 卡拥有独立的处理器和缓存。它执行所有 RAID 计算,例如条带化、镜像和奇偶校验,而无需占用服务器的主 CPU 资源。这种卸载机制可以提高性能并降低延迟。当您需要基于硬件的数据保护和更快的重建速度时,RAID 卡是您的理想之选。在许多企业环境中,RAID 卡简化了存储管理,并支持热插拔和分层存储等高级功能。 主要区别比较HBA和RAID,你会发现它们在架构和操作方面存在诸多差异:HBA 卡作为直通设备运行,使操作系统能够完全控制每个硬盘。这种设置非常适合软件 RAID。RAID卡在内部处理所有RAID逻辑。它们向系统呈现一个单一的逻辑卷,从而隐藏了底层驱动器。在数据中心,通常使用一个小型启动驱动器,然后让 HBA 或 RAID 卡管理其余的存储。两个控制器都支持大容量硬盘,但对于超过 2.1 TB 的硬盘,您可能需要升级到更新的 6 Gb/s SAS 或 SATA 控制器。提示: 如果您需要热插拔或分层存储,RAID 控制器和 HBA 解决方案都可以支持这些功能,具体取决于您的硬件。特征描述热插拔无需关闭系统即可更换硬盘分层存储支持 SAS、SATA 和 NVMe 驱动器,实现灵活的存储配置单控制器结合多种协议,降低复杂性和成本。您应该根据对硬件 RAID、软件 RAID 或高级存储功能的需求,在 RAID 卡和 HBA 卡之间进行选择。优点和缺点 HBA的优缺点在评估用于软件定义存储的 HBA 卡时,你会发现几个明显的优势:尤其是在标准以太网上使用 iSCSI HBA 时,您将受益于成本效益。这种方法避免了使用昂贵的专用硬件。您可以获得更高的数据传输速度。HBA 卡为信息流创建了一条直接高效的通道,这对于大型数据集和高性能应用程序至关重要。您将体验到更高的可靠性和稳定性。多路径和故障转移等功能可确保存储始终保持连接,并降低数据损坏或系统故障的风险。先进的纠错机制和强大的架构可帮助您以稳定的性能应对繁重的工作负载。 但是,您还必须考虑HBA卡在大规模部署中的局限性:局限性描述带宽有限老旧的互连线路(6-12 Gbps)在高负载下会发生故障。I/O性能瓶颈受限于协议效率低下和固件过时。可扩展性挑战难以在不停机或重新配置的情况下扩展存储阵列。兼容性风险较旧的控制器卡可能不支持 NVMe 或 Fibre Channel Gen7 等现代存储协议。更高的故障率供应商缺乏认证会导致驱动程序支持不稳定和停机时间增加。在关键任务环境中部署 HBA 卡之前,务必检查兼容性和固件支持情况。 RAID卡的优缺点RAID 卡为传统存储系统的数据保护和性能带来了几个关键优势:通过镜像和奇偶校验实现数据冗余,即使某个驱动器发生故障,也能保证数据可用。最好的 RAID 控制器可以在硬盘故障后自动重建数据,从而最大限度地减少停机时间。由于单个节点崩溃不会导致整个阵列瘫痪,因此可靠性更高。这种设置可以保持数据一致性并防止数据丢失。您可以看到更高的硬盘和固态硬盘性能。RAID 卡通过允许跨多个驱动器同时进行读写操作来提高吞吐量。您可以通过各种 RAID 级别(例如 RAID 1、RAID 5 和 RAID 6)享受内置的数据保护。RAID 控制器通过执行数据条带化等复杂操作来管理硬盘,数据条带化会将数据分割成多个数据块,并一次性写入多个硬盘。此过程可提高性能,尤其是在将 RAID 控制器用于 SSD 存储时。 尽管有这些优势,但在软件定义存储环境中使用 RAID 卡时,您仍会面临一些挑战:软件 RAID 依赖 CPU 进行管理,因此可能会产生性能开销,从而降低系统速度。您可能会发现 RAID 级别有限,从而限制了您的灵活性。可能会出现可扩展性问题,因为修改软件 RAID 设置既复杂又有风险。操作系统依赖性意味着 RAID 阵列的完整性直接与操作系统相关,如果操作系统出现故障,则可能会导致问题。在 I/O 密集型环境中,软件 RAID 可能无法与硬件解决方案相匹配,从而导致高负载性能受限。在 JBOD 模式下使用 RAID 控制器时,ZFS 可以创建多设备虚拟设备 (vdev),但控制器仍然独立管理存储。这种设置可能会导致性能问题和数据完整性隐患,因为 ZFS 操作与控制器管理之间可能存在冲突。 对比表:HBA 与 RAID您可以使用下表来比较适用于您存储环境的 HBA 和 RAID 卡解决方案:特征/方面HBA卡RAID卡成本更低,尤其是在使用 iSCSI 和标准以太网时。更高级别,需要专用硬件表现直接访问能力强,但受限于互连和固件在顺序和随机 I/O 方面表现出色,尤其是在配备缓存和 SSD 的情况下。数据保护依赖于软件 RAID(例如 ZFS、vSAN)内置冗余(镜像、奇偶校验、热备)可扩展性大型阵列的挑战使用高级控制器会更容易兼容性可能缺乏对最新协议的支持支持范围广,但可能限制高级SDS功能缓存利用率无车载缓存板载缓存可提升性能并降低延迟JBOD模式原生支持支持,但可能与 ZFS 等 SDS 冲突。软件 RAID 效率高,尤其是在使用现代 CPU 和 ZFS 时。可能受限于控制器抽象SSD优化取决于HBA型号最佳 SSD RAID 控制器可最大限度地提高 SSD 性能可靠性具有先进的纠错能力,但未经认证时故障风险较高。最佳 RAID 控制器提供强大的保护和自动重建功能您应该根据对性能、数据保护以及与软件定义存储平台兼容性的需求,在 HBA 卡和 RAID 卡之间进行选择。最佳 RAID 控制器通常能为 SSD 和 HDD 阵列提供卓越的性能和可靠性,但 HBA 卡则为现代 SDS 解决方案提供了灵活性和成本优势。 软件定义存储的性能 SDS 与 HBA在软件定义存储环境中使用 HBA 可获得最大的灵活性。HBA 充当直通设备,允许操作系统或存储软件直接管理每个驱动器。这种设置与 vSAN 和 ZFS 等平台配合良好,这些平台由软件处理冗余和数据保护。您可以轻松扩展存储并适应不断变化的工作负载需求。由于没有硬件 RAID 逻辑,因此可以避免额外的开销,从而提高实际工作负载下的性能,尤其是在使用高端 SSD 阵列时。但是,您必须确保 CPU 和内存资源充足,因为软件 RAID 计算会占用主机资源。特征JBOD(HBA)RAID控制器数据管理由软件/操作系统管理由硬件 RAID 逻辑管理冗余由软件处理(例如,vSAN、ZFS)内置冗余功能表现灵活,无 RAID 开销硬件缓存可能提供低延迟。用例非常适合软件定义存储解决方案适用于需要 RAID 逻辑的环境 SDS 中的 RAID 卡当您需要高性能和高可靠性时,硬件 RAID 控制器将是您的理想之选。这些控制器如同微型计算机,运行专用固件来管理 RAID 算法,并利用板载缓存缓冲 I/O。这种架构能够减少 CPU 中断和上下文切换,从而提升 IOPS 并降低延迟。在数据库或 AI 应用等具有大量随机读写工作负载的环境中,硬件 RAID 控制器能够发挥最佳性能。板载缓存,尤其是在电池供电的情况下,能够显著提升写入速度并缩短应用程序等待时间。RAID 控制器支持多种 RAID 级别和热备管理等高级功能,从而增强 HDD 和 SSD 阵列的可靠性和性能。 硬件 RAID 控制器充当嵌入服务器的微型计算机,运行专用固件,管理 RAID 算法,并使用板载缓存缓冲 I/O,从而减少 CPU 中断和操作系统级别的上下文切换。该架构提高了随机读写工作负载的 IOPS 并降低了延迟,使其成为业务关键型应用程序的理想选择。企业级硬件 RAID 控制器支持多种 RAID 级别(例如 0、1、5、6、10)和高级功能,如热备管理和预测性驱动器分析,从而提高可靠性和性能。软件 RAID 具有成本效益高和灵活性强的优点,因此适用于 CPU 资源充足的开发环境、小型文件服务器和家庭实验室。然而,软件 RAID 在高需求场景下性能可能不佳,除非与高端 SSD 和足够的 CPU 余量配合使用,否则更适合非关键任务部署。 vSAN、ZFS 和 AI 工作负载部署 vSAN、ZFS 或 AI 工作负载时,您会明显感受到差异。vSAN 和 ZFS 都倾向于直接访问驱动器,这可以通过 HBA 实现。这种方法提供了灵活性,并允许您使用高级软件功能进行数据保护和恢复。对于 AI 工作负载,您通常需要尽可能低的延迟和最高的 IOPS。在这种情况下,带有专用缓存和 RAID 逻辑的 RAID 控制器可提供卓越的性能,尤其是在使用 SSD 存储时。您应该根据工作负载需求选择合适的控制器。如果您优先考虑灵活性和软件定义存储功能,请选择 HBA。如果您需要为关键任务型 AI 或数据库工作负载提供最高的性能和可靠性,则支持 SSD 的 RAID 控制器是最佳选择。 数据保护和冗余RAID 和数据保护在企业存储中,RAID 是实现强大数据保护的保障手段。RAID 5、6 和 10 等不同级别在性能、冗余和容量方面各有侧重。RAID 5 兼具速度和容错能力,因此常用于服务器。RAID 6 通过增加双重奇偶校验来提升数据保护能力,这意味着即使丢失两块硬盘,数据也不会丢失。RAID 10 结合了镜像和条带化技术,兼具高性能和高冗余性,但需要更多磁盘,成本也更高。使用具有冗余功能的 RAID 配置可以显著降低数据丢失的风险。然而,RAID 无法防止意外删除或网络攻击。为了确保数据安全,始终需要维护外部备份。 RAID 5:兼顾性能、冗余和容量。RAID 6:通过双重奇偶校验提供增强的容错能力。RAID 10:提供高性能和冗余性,但成本较高。冗余的 RAID 级别可以降低数据丢失的风险。RAID 无法防止因意外删除或网络威胁造成的数据丢失。 使用 HBA 的软件 RAID通过将软件 RAID 与 HBA 卡结合使用,您可以实现灵活的数据保护。HBA 卡充当直通卡,使您的软件能够直接管理每个驱动器。这种设置非常适合 ZFS 或 Ceph 等平台,这些平台需要高级数据完整性功能。支持 SAS-4、三模功能和 PCIe 5.0 集成的现代 HBA 卡可提升性能和可靠性。您可以获得高达 50% 的 IOPS 提升和更低的能耗,从而支持绿色数据中心计划。HBA 卡中的 IT 模式固件可减少瓶颈,从而为软件定义存储提供更佳的性能。光纤通道 HBA 卡可提供超低延迟,这对于高可用性集群至关重要。您应该根据工作负载和数据保护需求选择最佳的 RAID 控制器或 HBA 卡。 SDS 中的可靠性部署软件定义存储时,可靠性至关重要。SAS HBA 卡因其性能稳定可靠且数据完整性强,在大多数部署中占据主导地位。三模 HBA 支持 NVMe over Fabrics,可提升 IOPS 并增强可靠性。为避免 RAID 控制器瓶颈并最大限度地提高数据完整性,应使用 IT 模式固件。新型 HBA 卡能耗更低,有助于您实现运营和环境目标。优秀的 RAID 控制器提供自动重建和高级纠错功能,确保数据安全。配备电池备份缓存的 RAID 卡可在断电期间保护数据,从而增加一层数据保护。为实现最高的可靠性和性能,硬件配置应始终与软件定义存储平台相匹配。提示:即使面对意外故障,也务必将 RAID 与定期备份相结合,以确保数据得到全面保护和数据完整性。部署注意事项 服务器兼容性在部署任何存储解决方案之前,您需要检查服务器兼容性。戴尔、HPE、联想和超微等主流品牌提供的服务器均支持 HBA 和 RAID 控制器。您应该验证固件版本和接口类型。许多企业级服务器支持 SAS、SATA 和 NVMe 硬盘。如果您计划使用 SSD 或 NVMe 硬盘,请选择与您的硬件匹配的 SSD RAID 控制器或 NVMe RAID 控制器。您必须确保您的控制器支持最新协议并提供最佳性能。某些服务器需要专用控制器,因此您应该查阅供应商文档。兼容性会影响性能、数据完整性和可靠性。 何时避免使用 RAID 卡在某些软件定义存储环境中,应避免使用 RAID 卡。如果您部署了 ZFS、vSAN 或 Ceph,则需要直接访问每个驱动器。RAID 控制器可能会干扰软件 RAID 逻辑并降低性能。您可能会遇到硬件和软件管理之间的冲突,从而危及数据完整性。当使用 SSD 阵列处理高性能工作负载时,使用 HBA 的软件 RAID 通常能提供更好的灵活性。如果您需要快照或精简配置等高级功能,也应避免使用 RAID 卡。在云原生部署中,软件 RAID 可提供更便捷的扩展性和集成性。提示:务必检查您的 SDS 平台是否推荐使用 JBOD 模式或直接驱动器访问。这可确保最佳性能和数据完整性。 实际场景您可以通过根据工作负载选择合适的控制器来优化存储部署。对于需要高随机 IOPS 的数据库服务器,带缓存的 RAID 控制器可以提升性能。如果您运行 AI 工作负载,请选择支持 SSD 和 NVMe 的控制器以实现低延迟。在备份服务器或文件存储中,使用 HBA 卡的软件 RAID 可以节省成本并提高灵活性。对于停机时间不可接受的关键任务型应用,您应该使用硬件 RAID。对于家庭实验室或开发环境,软件 RAID 可以提供更大的控制权和更便捷的扩展性。在选择 HBA 卡和 RAID 控制器时,务必权衡性能、可靠性和数据完整性。设想推荐解决方案原因数据库服务器RAID控制器高性能、冗余人工智能工作负载用于 NVMe/SSD 的 RAID 控制器低延迟,最大IOPS备份/文件存储HBA + 软件 RAID经济高效,灵活家庭实验室/开发环境HBA + 软件 RAID易于扩展和控制云原生SDSHBA + 软件 RAID可扩展性、集成性成本和采购建议 总拥有成本评估存储解决方案时,您需要考虑的不仅仅是硬件的初始价格。总体拥有成本 (TCO) 包括存储介质、控制器设计、许可、维护、功耗、散热以及未来的扩展成本。智能存储 HBA 和 RAID 适配器提供统一的固件和软件,从而简化管理并降低运营成本。您可以获得高达 40% 的性能提升和节能效果。HBA 的部署和管理可简化流程并提高资源利用率。这种方法有助于降低总体拥有成本,尤其是在需要灵活性的环境中。统一固件降低了复杂性。节约能源可降低运营成本。简化管理可降低维护成本。高效的资源利用可以提高投资回报率。 SDS 中的可扩展性部署软件定义存储时,必须考虑可扩展性。HBA 卡便于扩展,并可与 ZFS 和 Ceph 等平台集成。您可以添加驱动器或节点而无需进行重大重新配置。这种灵活性支持企业和云环境的快速增长。RAID 控制器为传统工作负载提供强大的性能,但您可能会面临厂商锁定和缓存故障的限制。选择 HBA 卡进行现代 SDS 部署可以避免这些风险。最佳的 RAID 控制器支持大型阵列和高级功能,但您需要权衡可扩展性和长期成本。 专家建议您应根据工作负载和部署目标选择合适的控制器。专家建议在软件定义存储环境(例如 ZFS 和 Ceph)中使用 HBA。RAID 控制器适用于传统的企业工作负载和关键任务型应用程序。现代数据中心通常避免使用 RAID 卡,以防止厂商锁定和缓存故障。最佳的 RAID 控制器可为 VMware 和数据库服务器提供高性能和高可靠性。使用 HBA 可以实现与 AI 工作负载的无缝集成,尤其是在 vSAN 和 ZFS 集群中。这种方法通过 JBOD 的灵活性,可节省 20-30% 的总体拥有成本。控制器类型缓存BBU/超级资本最佳用例风险等级入门级硬件 RAID小的选修的实验室,备份中等的中型企业中等的是的服务器,RAID 10低的高端企业大的是的VMware,数据库非常低HBA没有任何不适用ZFS,Ceph视情况而定提示:在为您的环境选择最佳 RAID 控制器或 HBA 之前,请务必评估您未来的增长计划和工作负载需求。  选择 HBA 卡可实现灵活性和直接驱动器管理,从而最大程度地发挥软件定义存储的优势。数据保护在任何部署中都至关重要。为获得最佳效果,请遵循以下步骤:请检查插槽兼容性,以防止带宽问题。选择合适的端口数量,以实现数据保护和冗余。请确认驱动程序和操作系统兼容性,以确保数据安全稳定。为了获得最佳数据保护,请确定您需要直通模式还是磁盘管理模式。SDS平台在软件层面处理数据保护。IT 模式下的 HBA 或 RAID 支持透明数据保护。硬件 RAID 可能会限制 SDS 中的数据保护。评估您的需求,以确保性能和数据保护之间达到适当的平衡。常问问题在软件定义存储中使用HBA的主要优势是什么?通过 HBA,您可以直接访问驱动器。这种设置使您的软件能够管理冗余和数据保护。您可以获得更大的灵活性,并更轻松地与 ZFS 和 vSAN 等平台集成。一台服务器中可以混用HBA控制器和RAID控制器吗?您可以混合使用这两种控制器,但务必谨慎规划。混合使用控制器可能会导致兼容性问题或使管理变得复杂。在混合使用之前,请务必查看您的 SDS 平台的相关建议。使用HBA的软件RAID会影响CPU性能吗?是的,软件 RAID 会使用服务器的 CPU 进行 RAID 计算。您应该确保系统拥有足够的处理能力来应对存储任务和应用程序工作负载。NVMe固态硬盘应该选择哪种控制器?您应该选择支持 NVMe 的 HBA 或 RAID 控制器。许多现代 HBA 都提供对 SAS、SATA 和 NVMe 的三模支持,为您提供高速存储的最佳灵活性。

留言

留言
如果您对我们的产品感兴趣并想了解更多详情,请联系我们。 请在此留言,我们会尽快回复您。

家

产品

联系我们

留言
如果您对我们的产品感兴趣并想了解更多详情,请联系我们。 请在此留言,我们会尽快回复您。